Keine Formel gefunden.
Dichte und Verteilungsfunktion
Wahrscheinlichkeit als Fläche
Die Wahrscheinlichkeit ist die Fläche unter der Kurve.
Bei Größen wie der Körpergröße fragt man nie nach einem einzelnen Wert. Genau 170,000 cm groß ist niemand. Man fragt nach einem Bereich, zum Beispiel „zwischen 160 und 180 cm“.
Die Antwort ist eine Fläche. Stell dir die Kurve als Hügel vor. Die Wahrscheinlichkeit ist, wie viel vom Hügel über deinem Bereich liegt. Das Zeichen musst du dafür nicht rechnen können. Es heißt nur „Fläche“.
Was die Zeichen bedeuten
- die Wahrscheinlichkeit für das, was in der Klammer steht
- die Größe, die du misst, zum Beispiel die Körpergröße einer zufälligen Person
- „X liegt zwischen und “, etwa zwischen 160 und 180 cm
- die Kurve (die Dichte). Wo sie hoch ist, gibt es viele Werte
- heißt nur: „die Fläche unter der Kurve von bis “
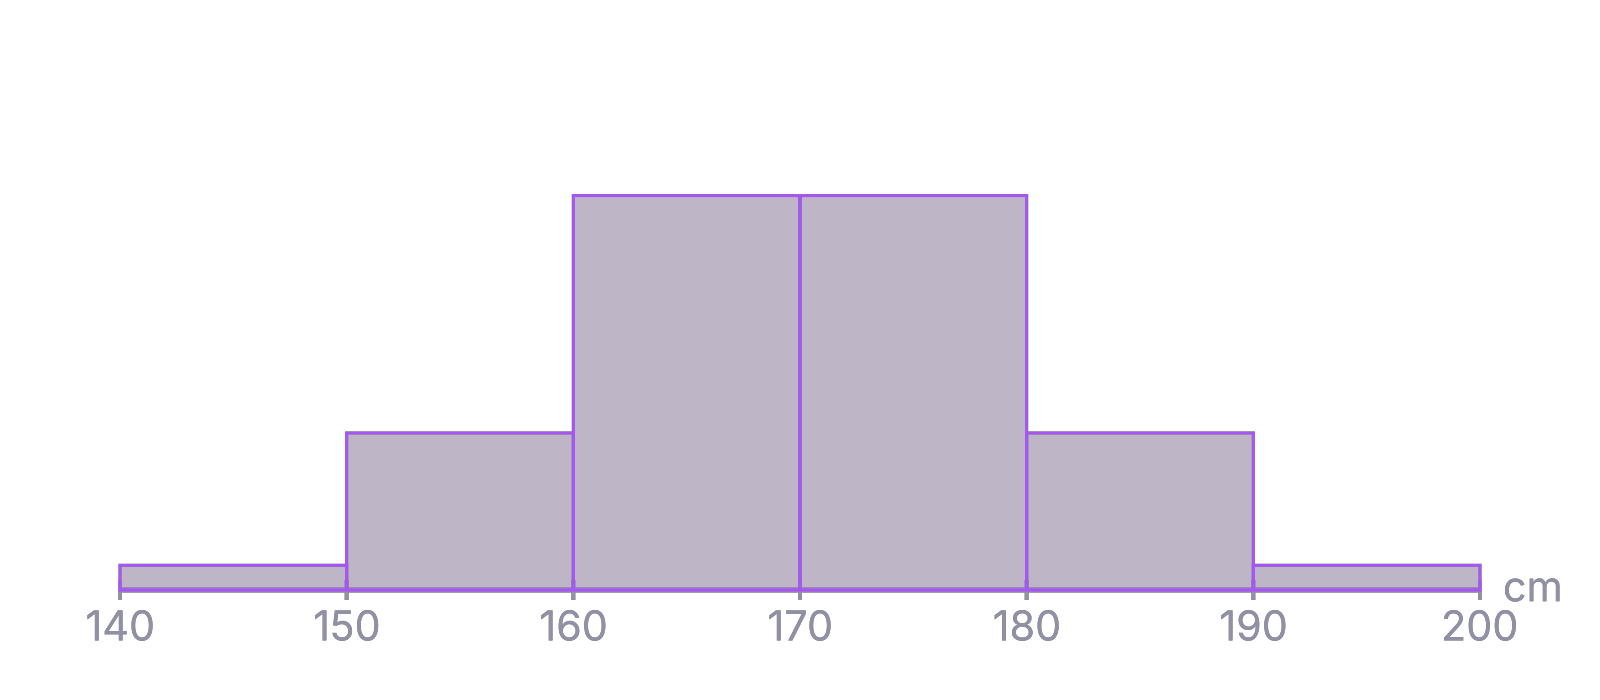
Aus den Säulen eines Histogramms wird die Kurve.
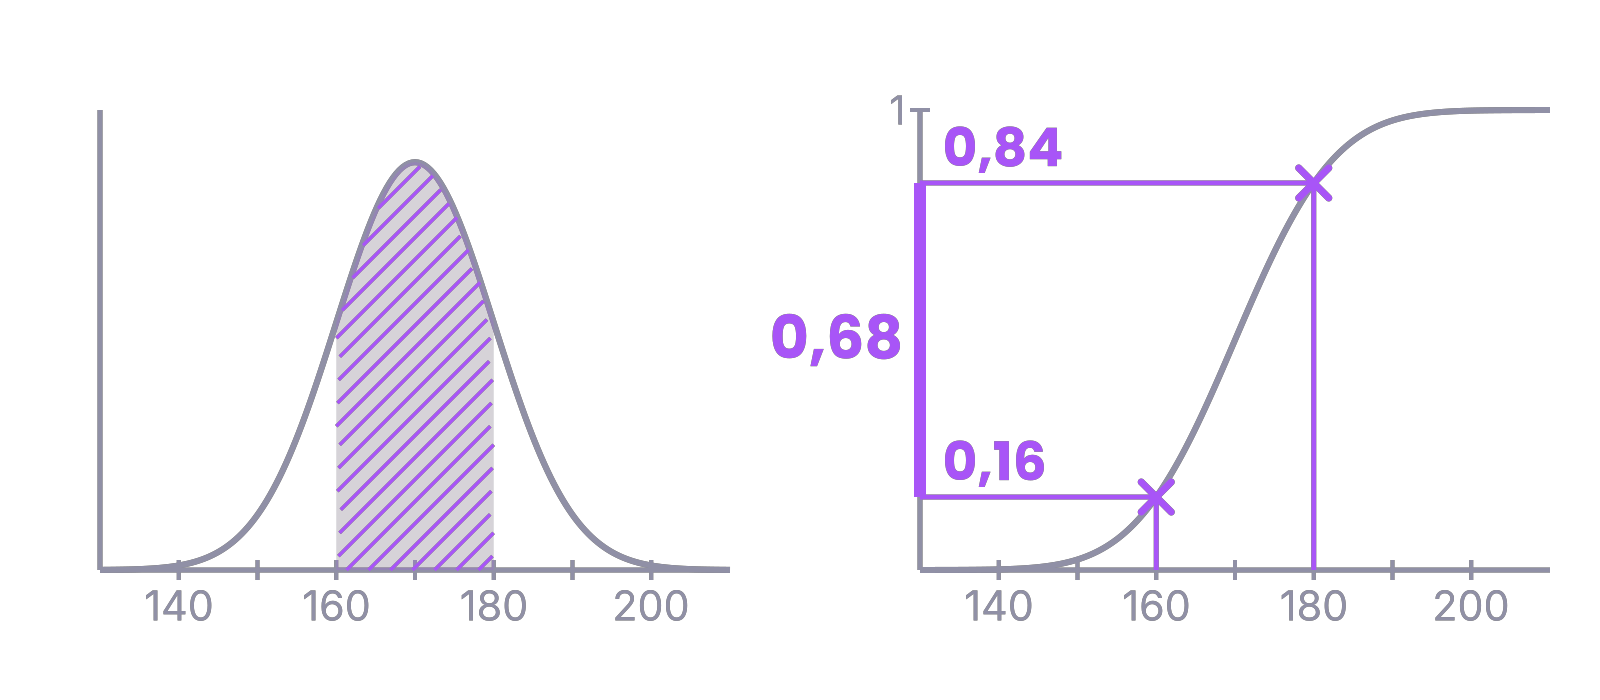
Links die Fläche zwischen 160 und 180 cm. Sie ist 0,68 groß.
Beispiel
Die Höhe der Kurve ist keine Wahrscheinlichkeit. Nur die Fläche ist eine.
Verwandte Formeln
Die Fläche ist immer 1
Die Kurve ist nie unter null, und die ganze Fläche darunter ist 1.
Irgendeine Größe hat jeder. Darum ist die ganze Fläche 1, also 100 %.
Die Kurve darf dafür schmal und hoch sein oder breit und flach. Wird sie schmaler, muss sie höher werden. Sonst würde Fläche fehlen.
Was die Zeichen bedeuten
- die Kurve liegt nie unter der Achse
- die Fläche von ganz links bis ganz rechts, also die ganze Fläche
- eins heißt 100 %
Die Glocke wird schmal und hoch, dann breit und flach. Die Fläche bleibt 1.
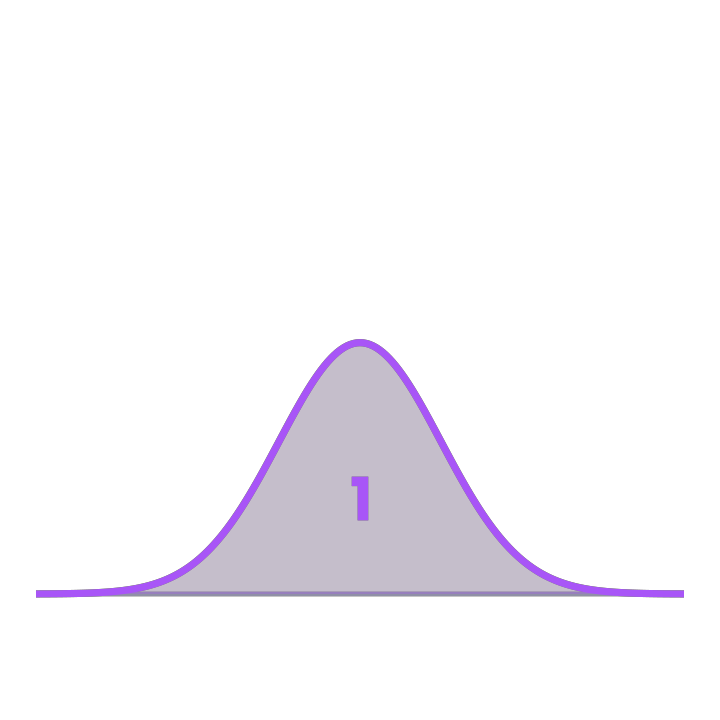
Die Kurve darf höher als 1 sein. Nur die Fläche muss 1 sein.
Verteilungsfunktion
F(x) sagt, wie viele höchstens x groß sind.
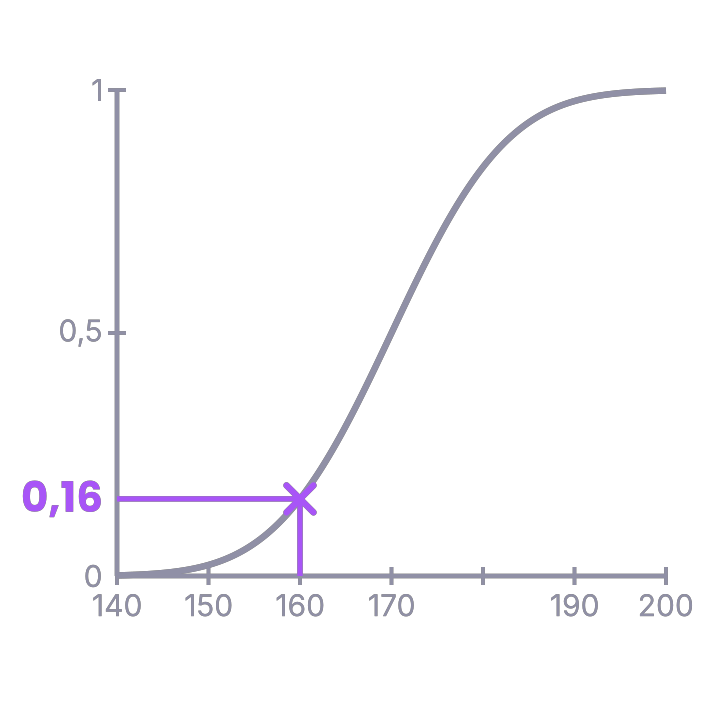
Nimm die Kurve und schieb einen Strich von links nach rechts. ist die Fläche links vom Strich.
Am Anfang ist links noch nichts: ist 0. Am Ende ist alles links: ist 1. Dazwischen steigt immer weiter an. So wird aus der Fläche links eine Höhe rechts – und die liest du einfach ab.
Was die Zeichen bedeuten
- die Verteilungsfunktion, auch kumulative Wahrscheinlichkeit
- „Wie wahrscheinlich ist ein Wert von höchstens ?“
- die ganze Fläche links von
Links füllt sich die Fläche, rechts wächst die Höhe mit.
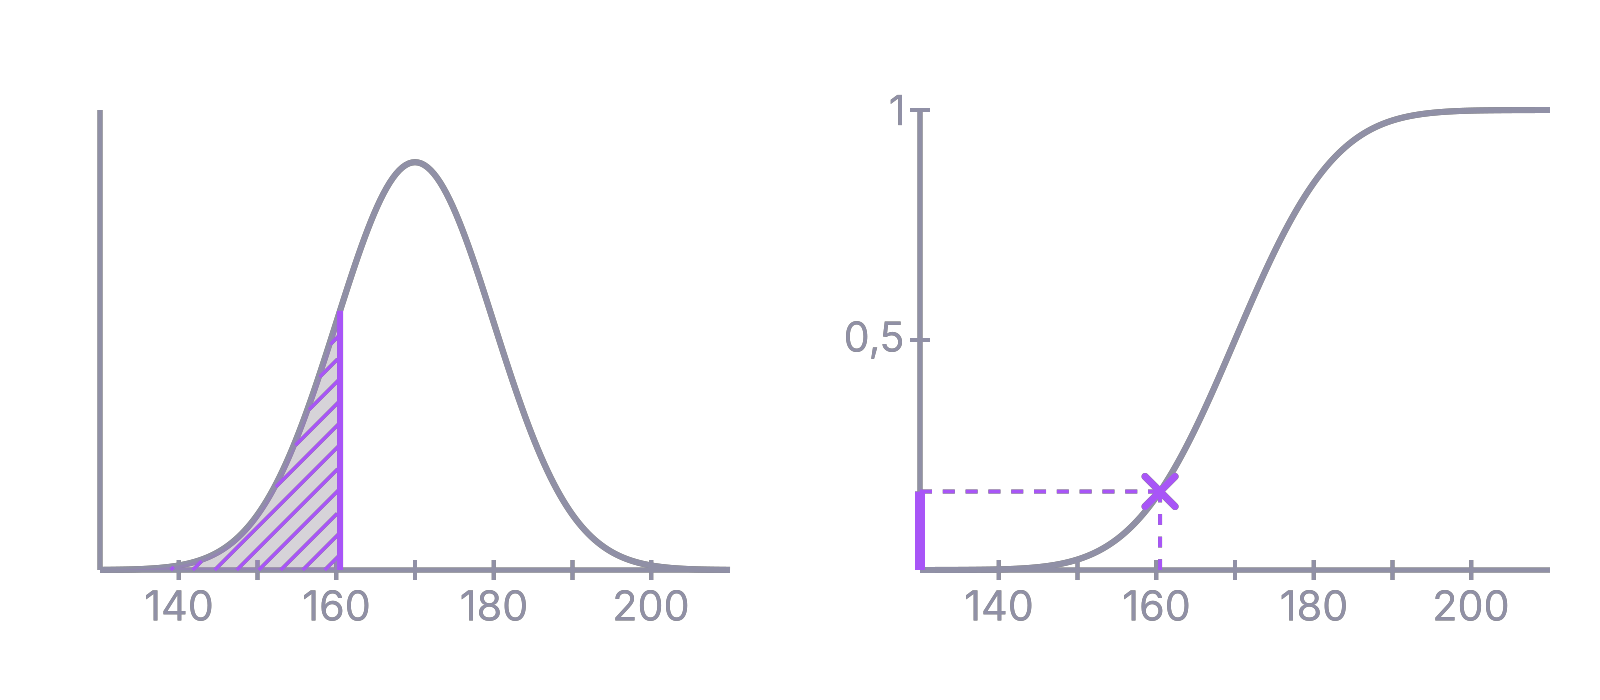
Ablesen: von 160 cm hoch zur Kurve, dann nach links. Dort steht 0,16.
Beispiel
ist immer „höchstens“, also die Fläche links. Für „mehr als“ brauchst du .
Verwandte Formeln
Höchstens, mehr als, zwischen
Mit F rechnest du jede Wahrscheinlichkeit aus.
Es gibt nur drei Fragen, und für jede eine Regel.
Höchstens 180 cm? Ablesen: . Mehr als 180 cm? Das ist der Rest. Von allem (1) ziehst du „höchstens“ ab. Zwischen 170 und 180 cm? Alles bis 180 minus alles bis 170. Übrig bleibt das Stück dazwischen.
Was die Zeichen bedeuten
- die Fläche links von (an der Kurve abgelesen)
- die ganze Fläche
- alles minus links, also die Fläche rechts von
- bis minus bis , also nur das Stück dazwischen
„Mehr als 180“: alles (1) minus „höchstens 180“ (0,84).
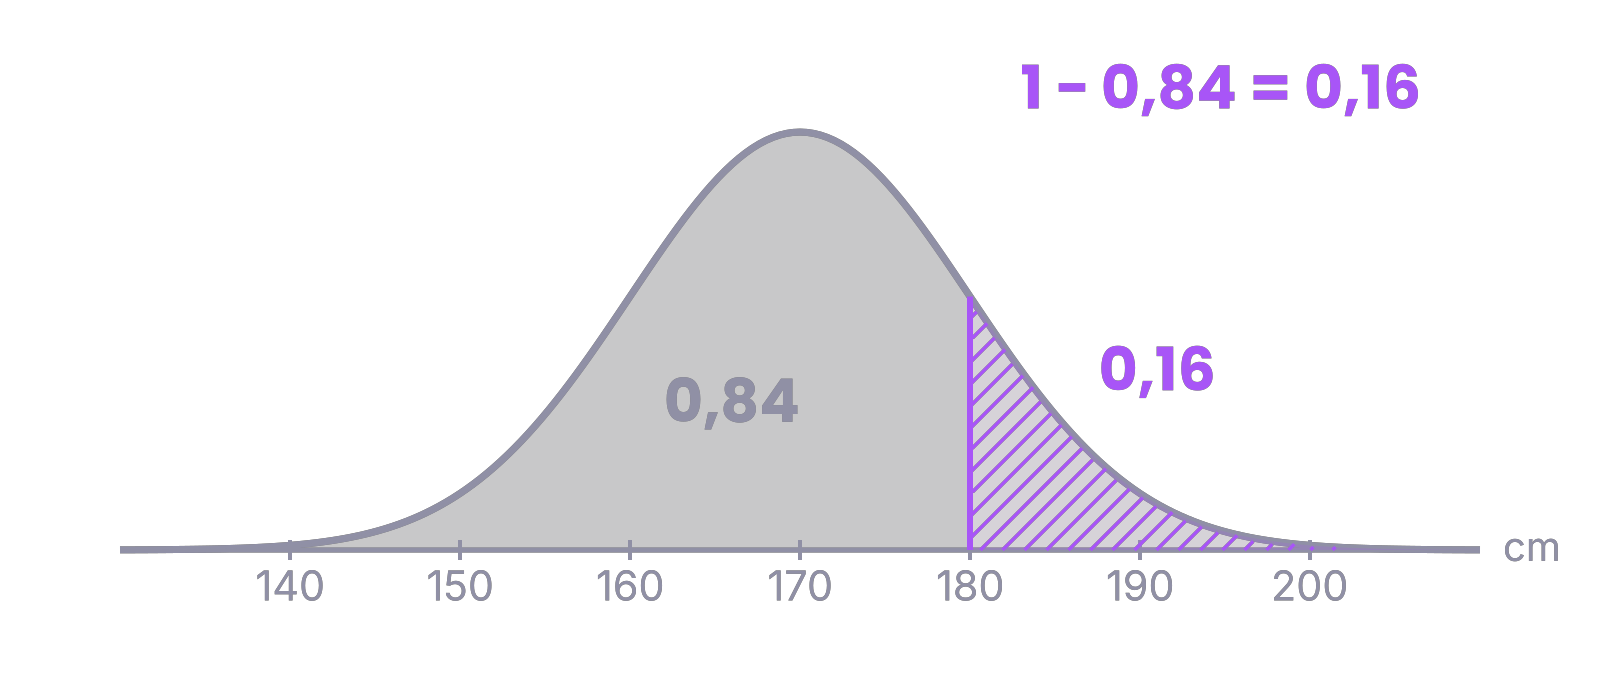
„Zwischen 160 und 180“: 0,84 minus 0,16 ergibt 0,68.
Beispiele
„Zwischen“ ist minus: . Nicht plus und nicht .
Verwandte Formeln
Warum F gegen 1 geht
Ganz links ist F fast 0, ganz rechts fast 1.
Je weiter rechts du bist, desto mehr Fläche liegt links von dir. Rechts bleibt immer weniger übrig.
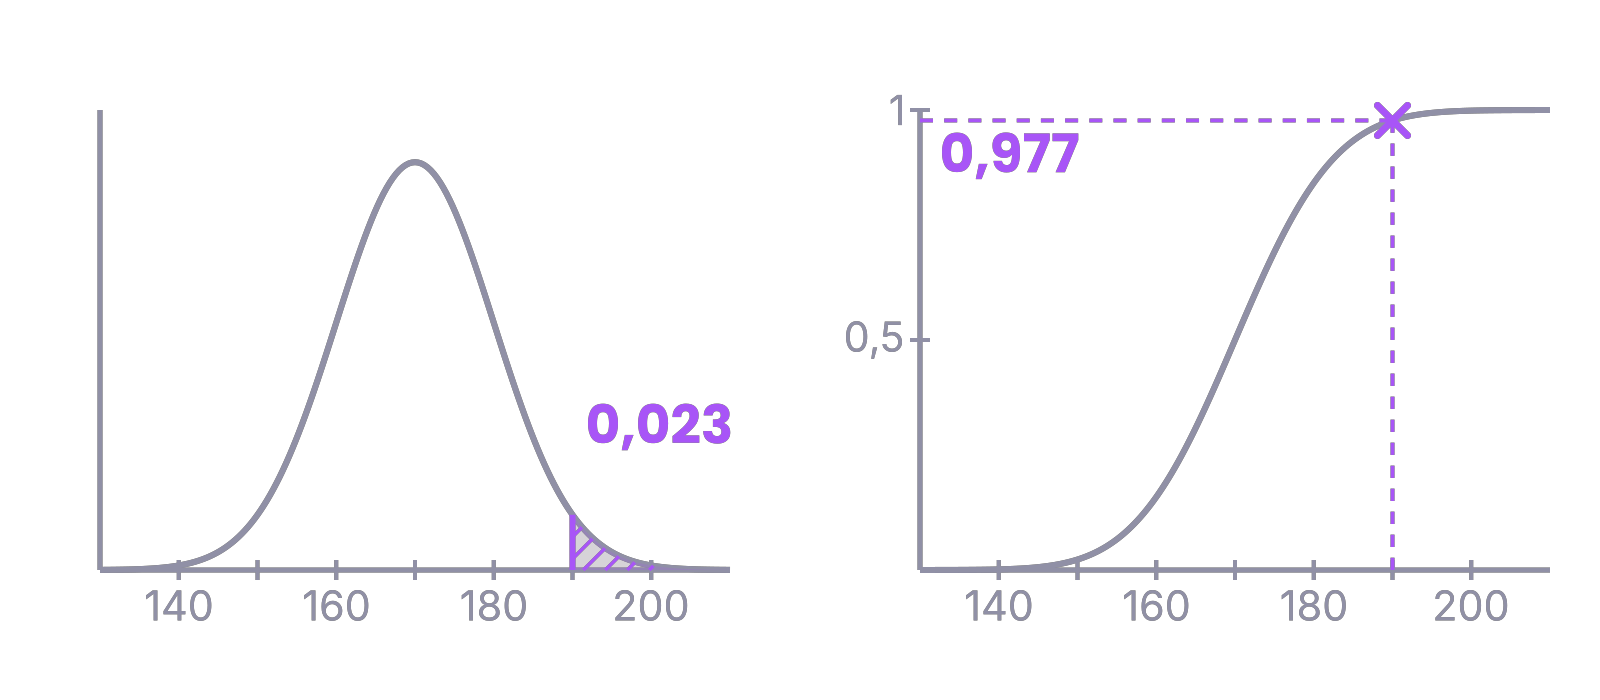
Bei 200 cm ist rechts fast nichts mehr: Kaum jemand ist größer. Links liegt dann fast alles, also fast 1. Ganz genau 1 wird es bei der Normalverteilung nie, weil die Kurve nie ganz null wird.
Was die Zeichen bedeuten
- „wenn immer größer wird“
- die Fläche links wird fast die ganze Fläche
Die Fläche rechts schrumpft: 0,159, dann 0,023, dann 0,001. F steigt auf fast 1.
Beispiel
Normalverteilung
Die Glockenkurve
Zwei Zahlen bestimmen die Glocke – wo sie steht (μ) und wie breit sie ist (σ).
Die Formel sieht wild aus. Du musst sie fast nie ausrechnen. Wichtig sind nur die zwei Zahlen darin.
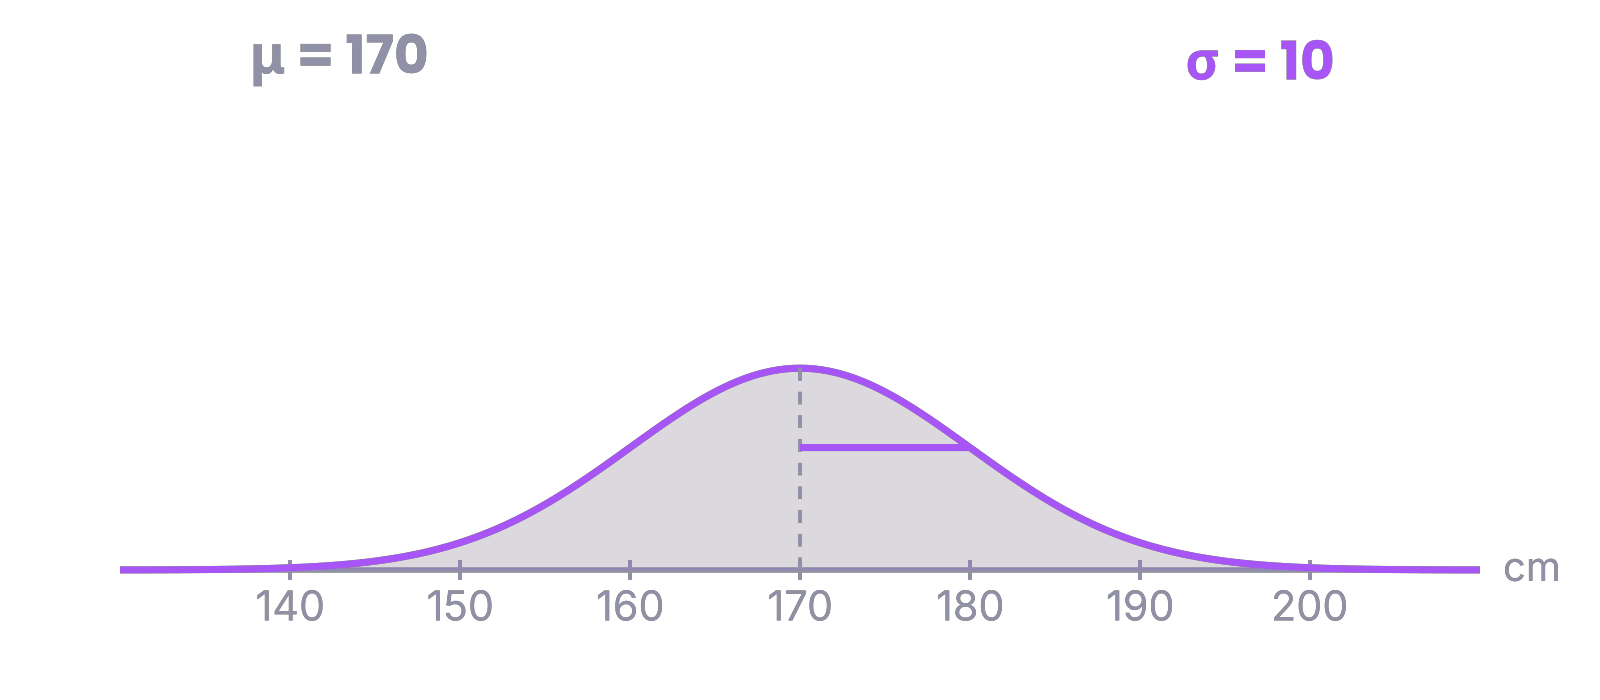
Ändert sich , rutscht die ganze Glocke nach links oder rechts. Ändert sich , wird sie breiter und flacher oder schmaler und höher. Die Form bleibt immer eine Glocke. Man schreibt kurz , hier .
Was die Zeichen bedeuten
- „mü“, der Mittelwert. Dort ist der Gipfel. Bei der Körpergröße 170 cm
- „sigma“, die Standardabweichung. Sie sagt, wie breit die Glocke ist. Hier 10 cm
- wie weit ein Wert vom Mittelwert weg ist
- sorgt dafür, dass die Kurve nach außen schnell flach wird
- macht die Glocke so hoch, dass die Fläche 1 ist
Erst ändert sich μ (die Glocke rutscht), dann σ (sie wird schmal oder breit).
Beispiel
In ist 100 die Varianz , nicht . In R schreibst du sd = 10.
Verwandte Formeln
68-95-99,7-Regel
So viele Werte liegen nah am Mittelwert.
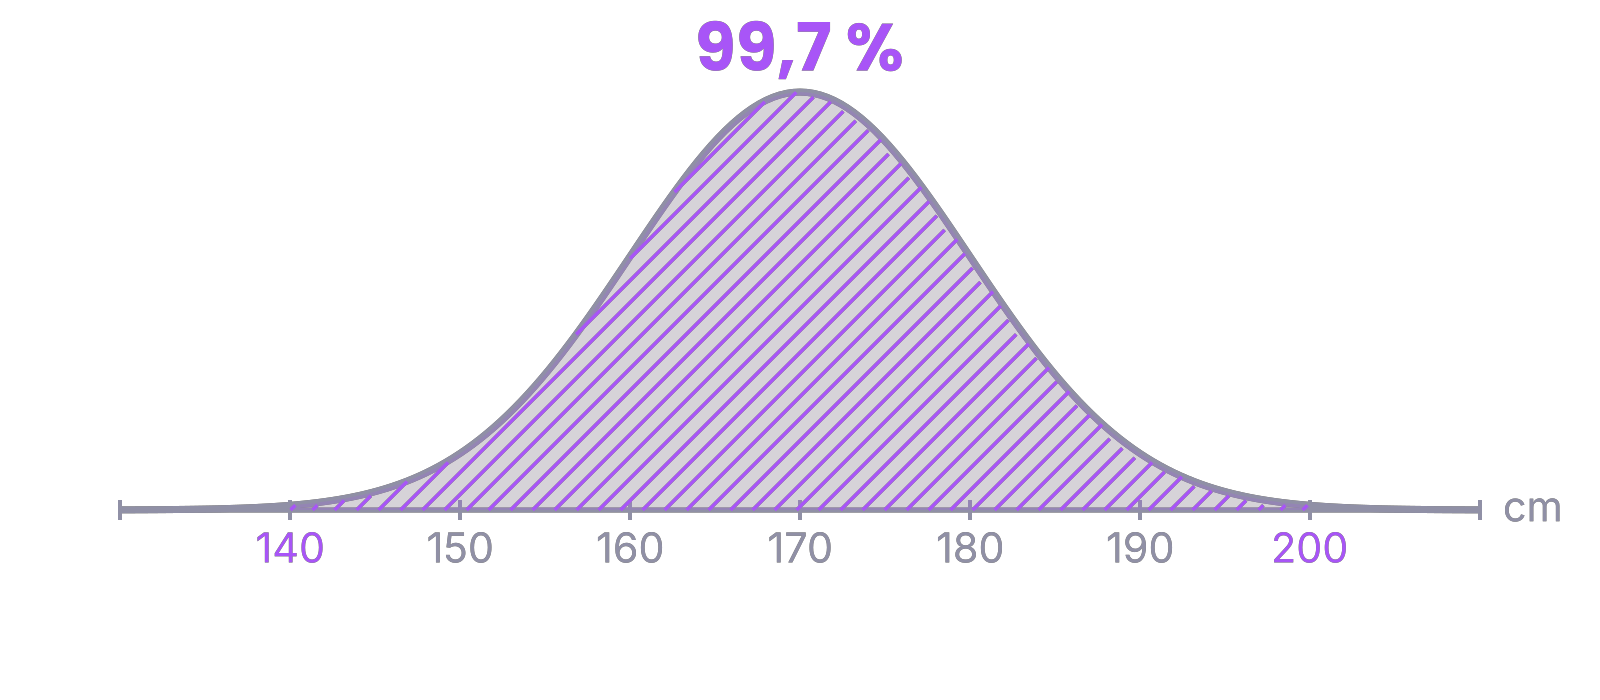
Bei jeder Normalverteilung ist es gleich. Rund zwei Drittel aller Werte liegen höchstens einen Schritt vom Mittelwert weg. Fast alle (95 %) liegen höchstens zwei Schritte weg.
Damit kannst du ohne Rechnen sagen: Bei 180 cm (ein Schritt über 170) sind schon 84 % kleiner. Denn 50 % sind unter 170, dazu kommt die Hälfte von 68 %, also 34 %.
Was die Zeichen bedeuten
- „vom Mittelwert eine Standardabweichung nach links bis eine nach rechts“, hier 160 bis 180 cm
- zwei Schritte nach jeder Seite, hier 150 bis 190 cm
Nacheinander: 160–180 cm (68 %), 150–190 cm (95 %), 140–200 cm (99,7 %).
Beispiel
Verwandte Formeln
z-Wert (Standardisieren)
Der z-Wert sagt, wie viele Schritte σ ein Wert vom Mittelwert weg ist.
Der z-Wert ist wie ein neues Lineal. Die Glocke bleibt genau gleich. Nur die Zahlen darunter ändern sich: Der Mittelwert wird zur 0, und ein Schritt wird zur 1.
Das ist praktisch: Für die Glocke mit 0 und 1 gibt es Tabellen (). Jede andere Normalverteilung rechnest du so auf sie um.
Was die Zeichen bedeuten
- dein Wert, zum Beispiel 185 cm
- wie weit er vom Mittelwert weg ist: cm
- in Schritten von gezählt: Schritte
- die Zahl der Schritte. Positiv heißt größer als der Mittelwert, negativ kleiner
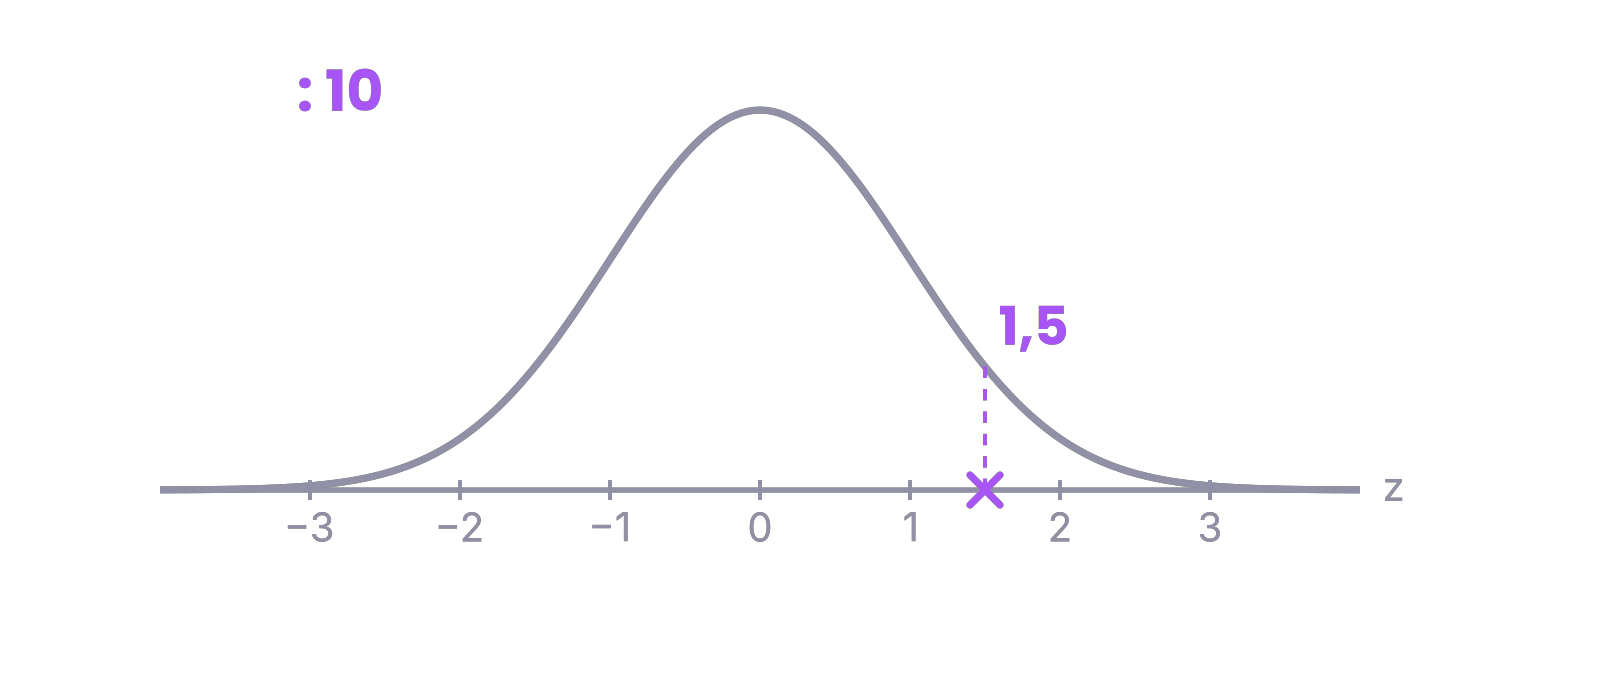
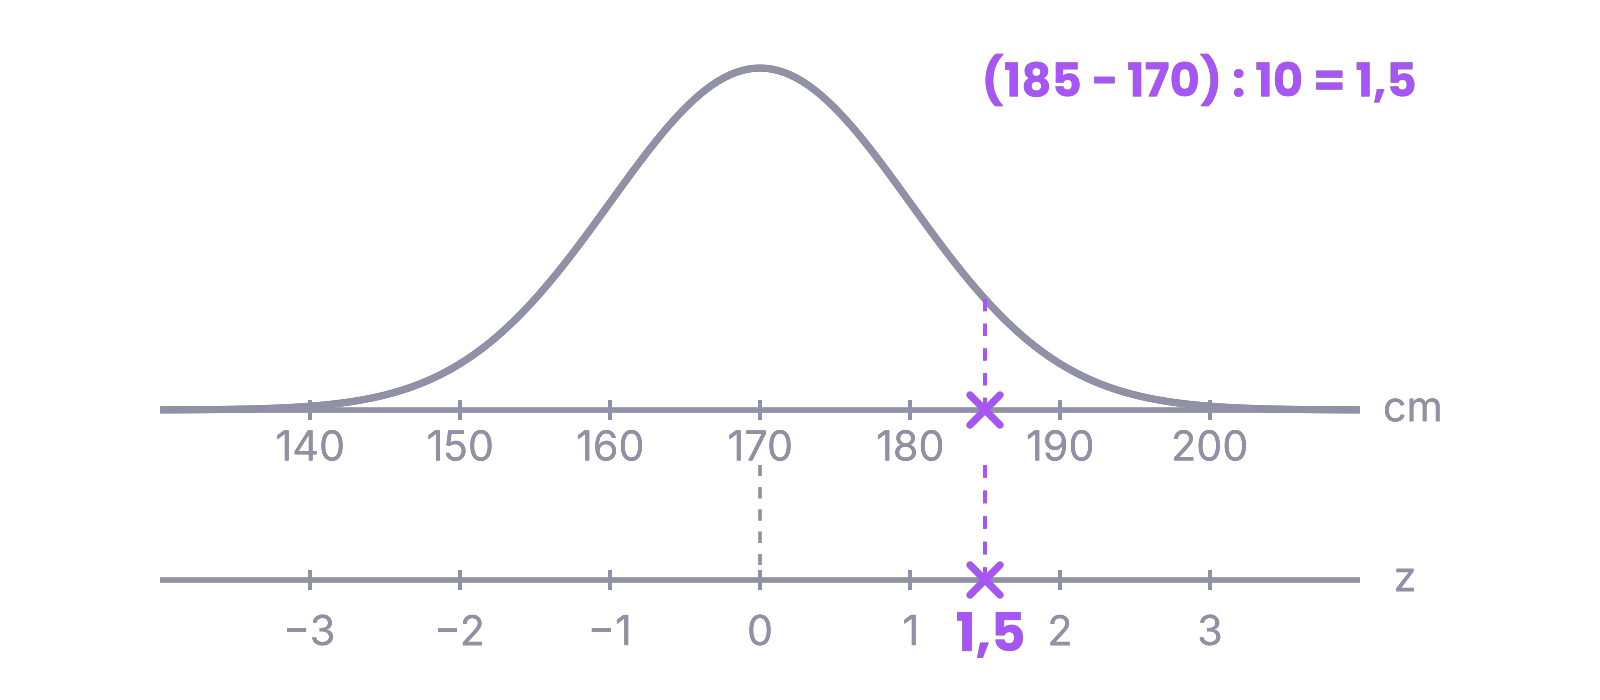
Erst minus μ (170), dann durch σ (10). Aus 185 cm wird 1,5.
Die cm-Achse und die z-Achse untereinander.
Beispiel
Verwandte Formeln
Symmetrie von Φ
Was links von −z liegt, ist genauso viel wie rechts von z.
Tabellen haben nur positive z-Werte. Was machst du mit ?
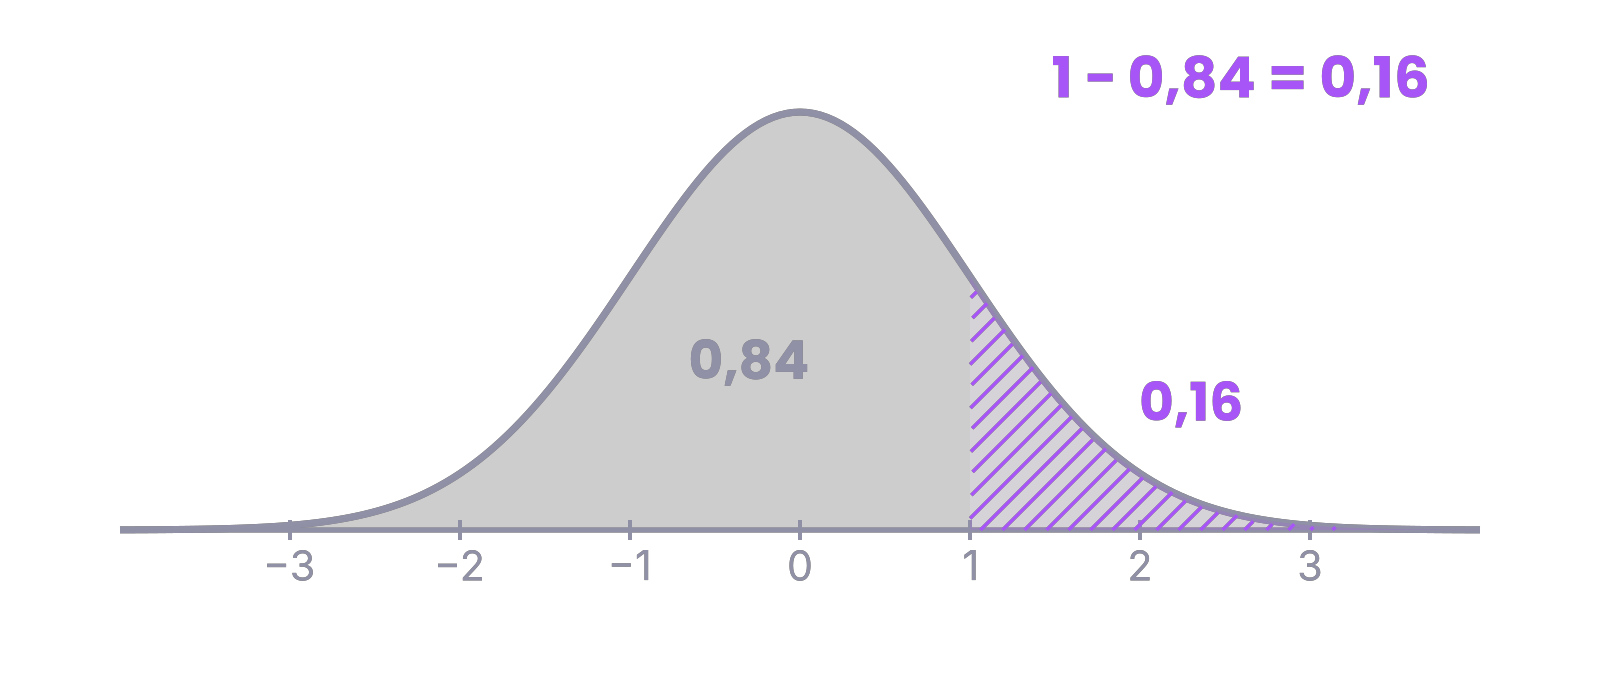
Die Glocke ist auf beiden Seiten gleich. Das Stück links von ist also genauso groß wie das Stück rechts von . Und rechts von ist „alles minus links“: .
Was die Zeichen bedeuten
- „Phi von z“: die Fläche links von bei der Glocke mit 0 und 1 (steht in der Tabelle)
- die Fläche links von der negativen Zahl
- die Fläche rechts von
Links von −1 ist so viel wie rechts von 1: 0,16.
Beispiel
Verwandte Formeln
Quantil
Das Quantil ist der Wert, unter dem ein bestimmter Anteil liegt.
Das ist das Ablesen andersherum. Nicht „Wert → Anteil“, sondern „Anteil → Wert“.
Du suchst in der Tabelle den z-Wert zu deinem Anteil. Dann rechnest du vom z-Lineal zurück aufs cm-Lineal: mal , plus .
Was die Zeichen bedeuten
- der Anteil, zum Beispiel 0,9 für 90 %
- der z-Wert zu diesem Anteil, aus der Tabelle (bei 90 %: 1,282)
- der gesuchte Wert: 90 % sind kleiner
Im zweiten Teil: von 0,9 nach rechts zur Kurve, dann hinunter. Dort steht 182,8 cm.
Beispiel
Verwandte Formeln
Kennwerte und Standardfehler
Mittelwert
Alle Werte zusammenzählen und durch ihre Anzahl teilen.
Das Summenzeichen sieht schwierig aus. Es heißt nur „alles zusammenzählen“.
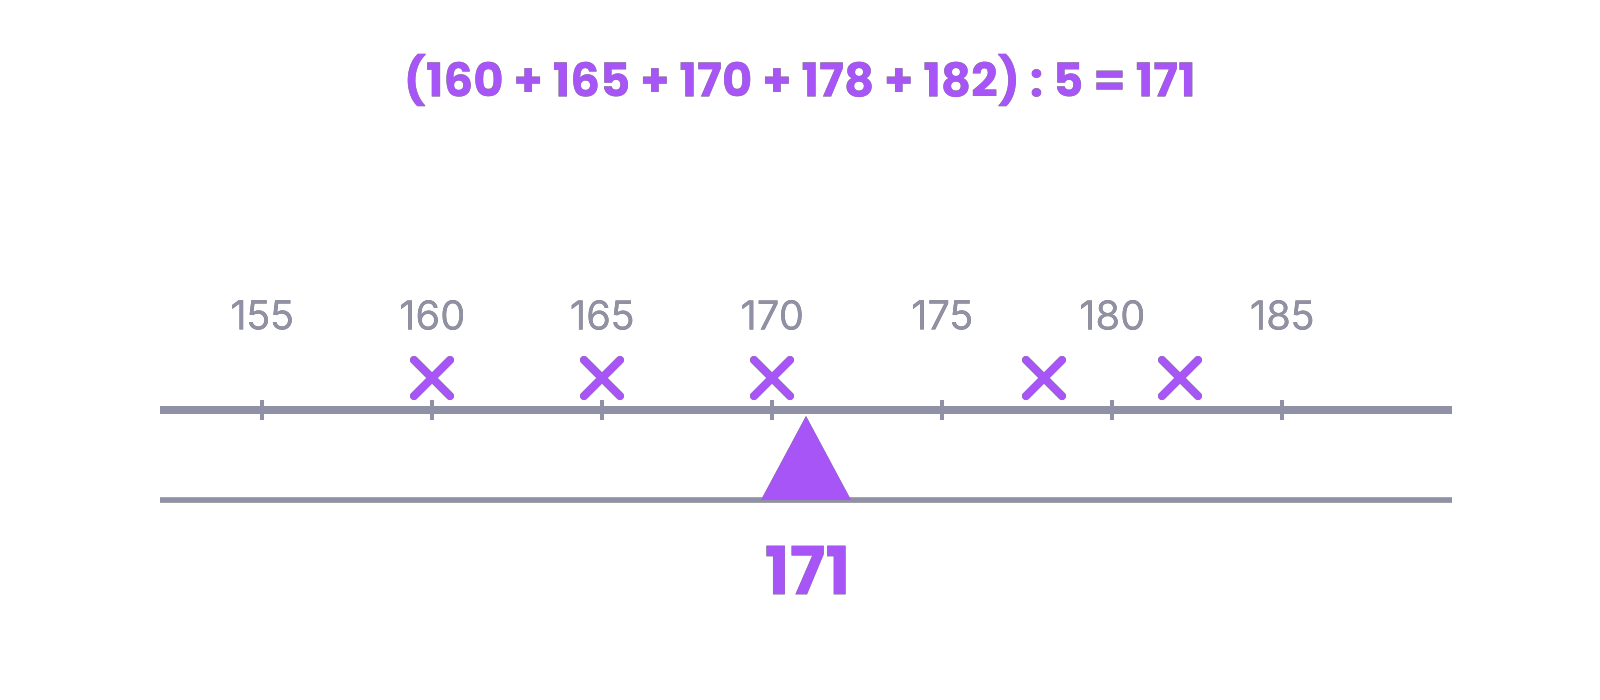
Du kannst dir den Mittelwert als Waage vorstellen. Alle Werte liegen als gleich schwere Gewichte auf einem Brett. Der Mittelwert ist die Stelle, an der das Brett im Gleichgewicht ist.
Was die Zeichen bedeuten
- „x quer“, der Mittelwert deiner Daten
- die einzelnen Werte: der erste, der zweite …
- wie viele Werte es sind
- „Summe“: alle Werte von der Nummer 1 bis zusammenzählen
Bei 171 ist das Brett im Gleichgewicht.
Beispiel
In R: mean(x, na.rm = TRUE). Ohne na.rm = TRUE kommt bei einem fehlenden Wert NA heraus.
Varianz und Standardabweichung
Wie weit die Werte im Schnitt vom Mittelwert entfernt sind.
Du willst wissen: Liegen die Werte eng zusammen oder weit verstreut? Dafür schaust du, wie weit jeder Wert vom Mittelwert weg ist.
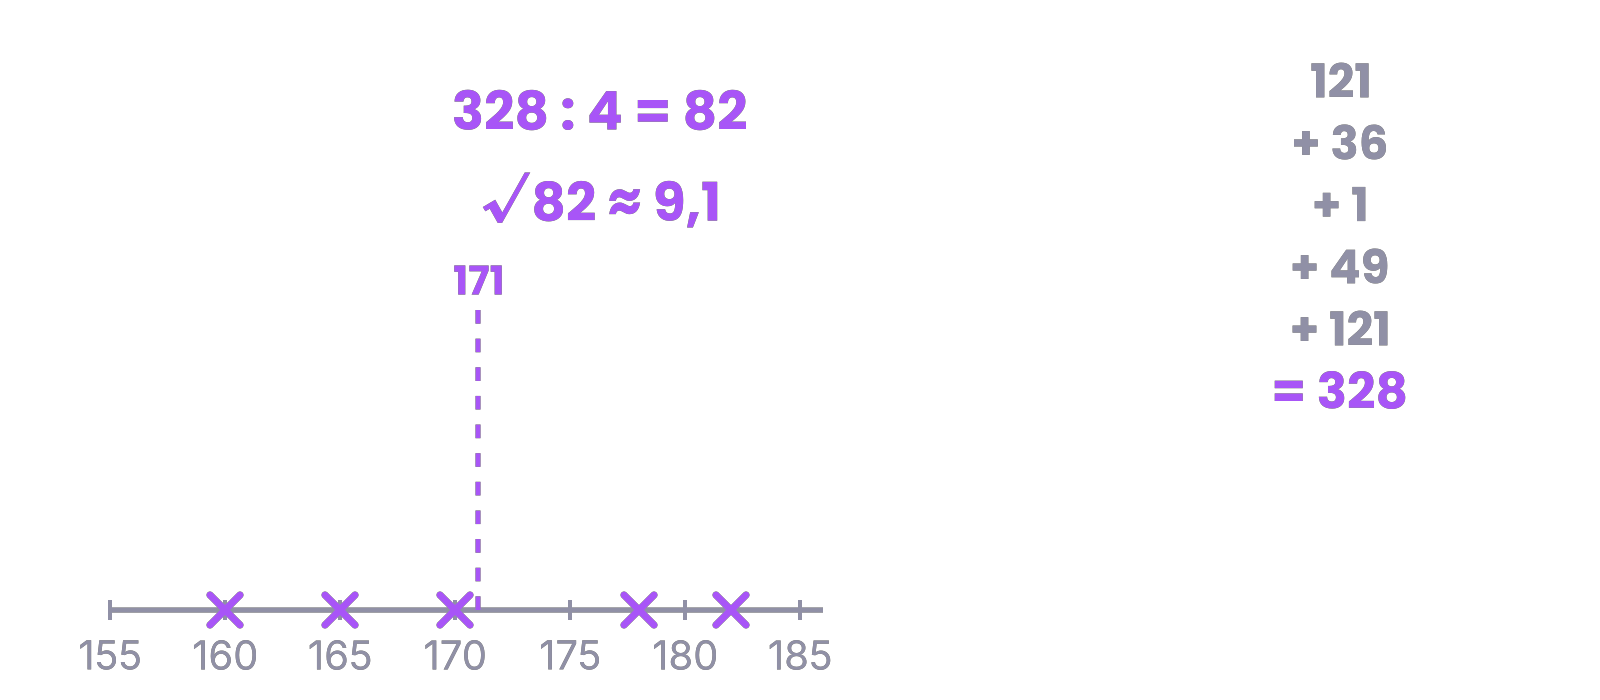
Einfach addieren geht nicht. Die Abweichungen nach unten (minus) und nach oben (plus) würden sich aufheben. Darum nimmt man jede hoch zwei: Aus der Abweichung wird ein Quadrat. Die Flächen der Quadrate zählst du zusammen und teilst durch . Am Ende ziehst du die Wurzel, damit wieder cm herauskommt.
Was die Zeichen bedeuten
- wie weit ein Wert vom Mittelwert weg ist (die Abweichung)
- hoch zwei, damit minus und plus sich nicht wegheben
- durch die Anzahl minus eins teilen
- die Varianz. Ihre Einheit ist „cm hoch zwei“
- die Standardabweichung: die Wurzel daraus, wieder in cm
Jede Abweichung wird zu einem Quadrat. Die Flächen werden zusammengezählt.
Beispiel
Geteilt wird durch , nicht durch . In R: var(x) und sd(x), beide schon mit .
Standardfehler
Wie genau der Mittelwert ist – nicht, wie verschieden die Tiere sind.
Einzelne Menschen sind sehr verschieden groß. Der Mittelwert von vier Menschen schwankt viel weniger: Große und Kleine gleichen sich aus.
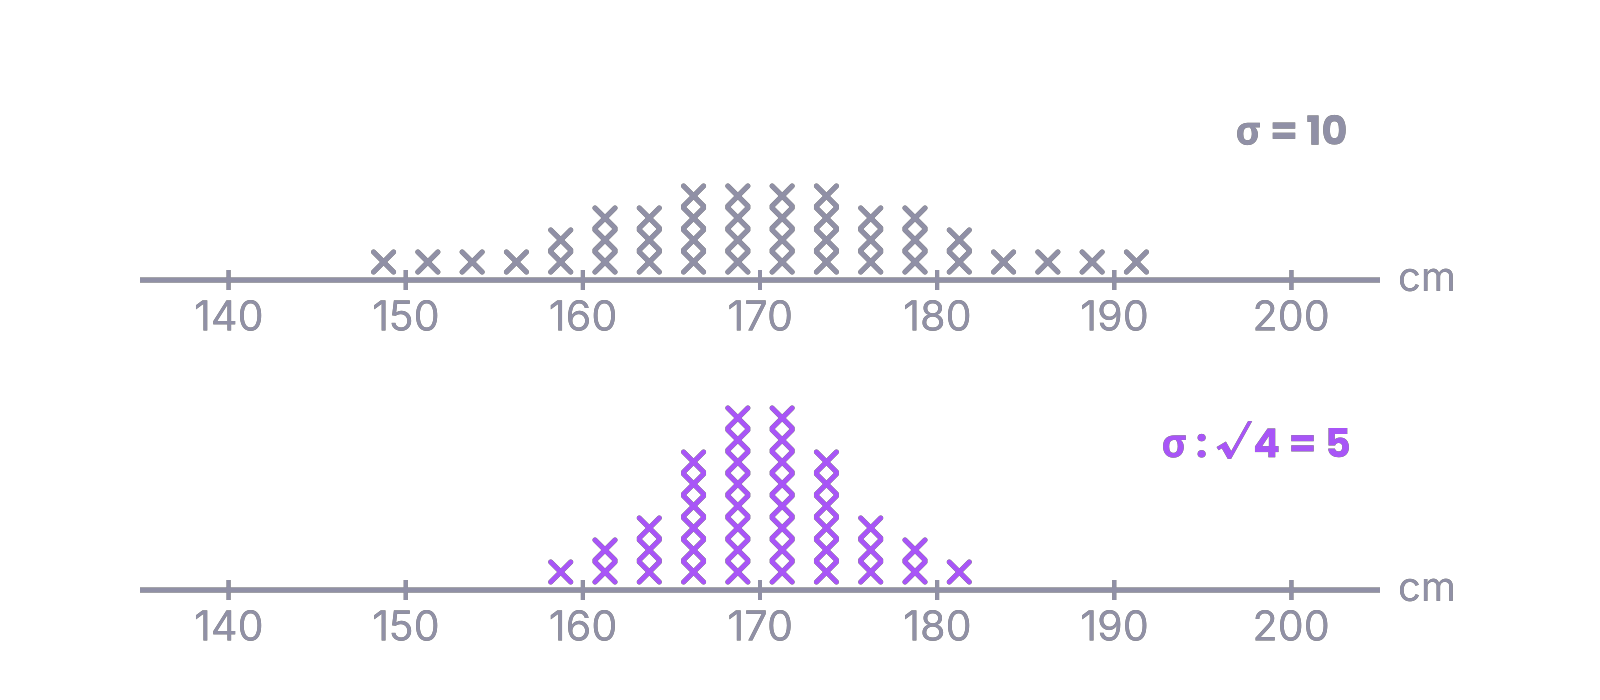
Der Standardfehler sagt, wie stark Mittelwerte schwanken. Je mehr Werte im Mittelwert stecken, desto kleiner ist er. Mit 4 Werten halbiert er sich (), mit 100 Werten wird er ein Zehntel.
Was die Zeichen bedeuten
- „Standardfehler“ (englisch standard error)
- die Standardabweichung der einzelnen Werte
- die Wurzel aus der Anzahl der Werte
Oben einzelne Körpergrößen, unten Mittelwerte aus je 4 Personen.
Mehr Daten machen die Glocken schmaler.
Beispiel
Standardabweichung = wie verschieden die einzelnen Werte sind. Standardfehler = wie genau der Mittelwert ist. Nicht verwechseln.
Verwandte Formeln
Varianz und Standardabweichung · Prüfgröße für einen Mittelwert
Testen
Nullhypothese und Alternativhypothese
H_A ist deine Vermutung, H_0 ist ihr Gegenteil.
Du vermutest etwas, zum Beispiel: Mehr Licht, mehr Sauerstoff bei der Wasserpest. Das ist .
ist das langweilige Gegenteil: „Licht hat keinen positiven Einfluss.“ Der Test prüft immer . Passen die Daten schlecht zu , verwirfst du sie – und das spricht für .
Was die Zeichen bedeuten
- „H A“, die Alternativhypothese: das, was du zeigen willst (manchmal )
- „H null“, die Nullhypothese: „es gibt keinen Effekt“
- „rho“, der echte Zusammenhang in der ganzen Natur (nicht nur in deinen Daten)
- positiver Zusammenhang: je mehr das eine, desto mehr das andere
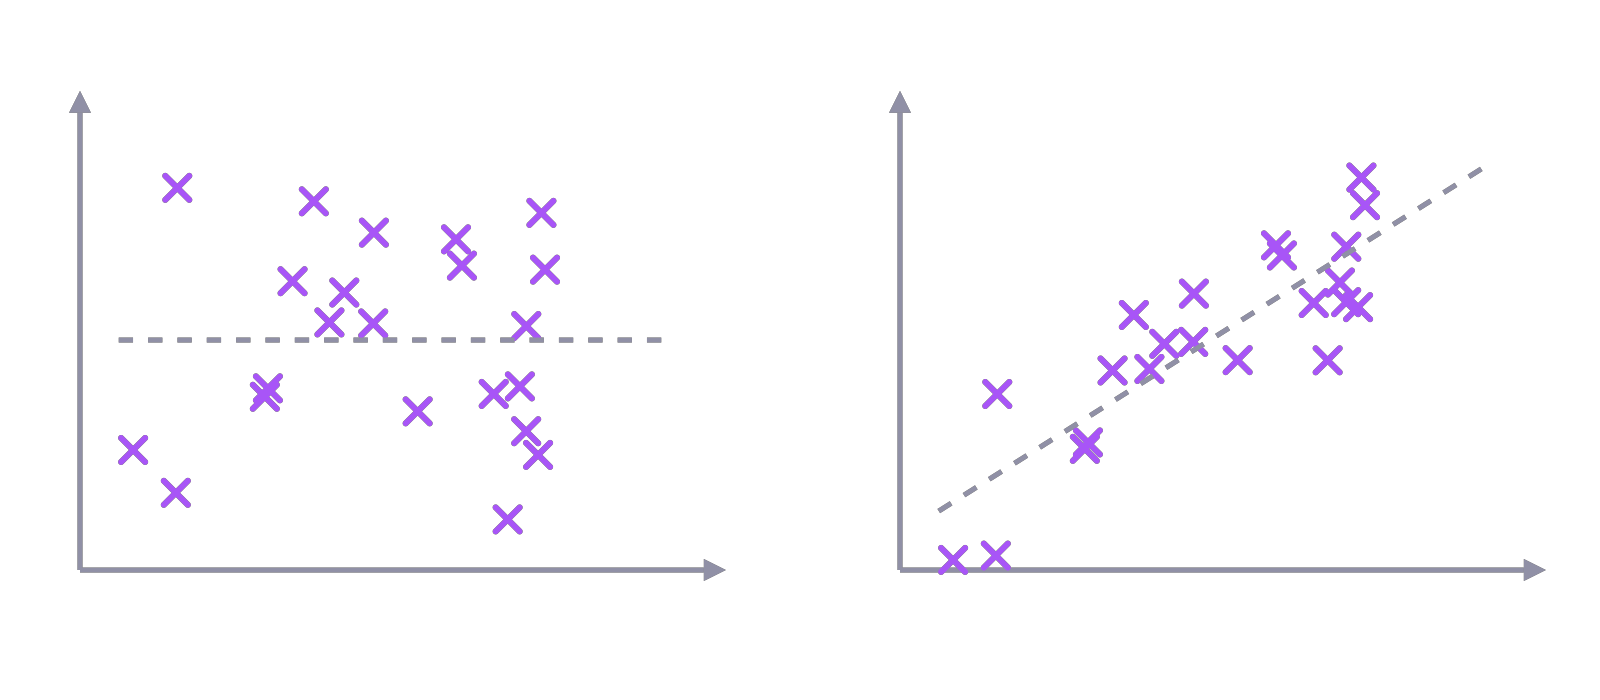
Links so sähe es unter H₀ aus (keine Richtung), rechts unter Hₐ (steigend).
Beispiel
Schreib beide Hypothesen mit dem echten Beispiel auf, nicht nur mit Zeichen. Bei „irgendein Unterschied“ (ohne Richtung) heißt es und .
Verwandte Formeln
p-Wert
Wie überraschend deine Daten wären, wenn H₀ stimmt.
Der Test tut so, als ob stimmt. Dann fragt er: Wie oft käme so ein Ergebnis zufällig heraus?
Das ist die Fläche der Glocke ab deinem Ergebnis nach außen. Ist sie klein, wäre dein Ergebnis unter ein großer Zufall. Dann glaubst du nicht mehr.
Was die Zeichen bedeuten
- eine Wahrscheinlichkeit zwischen 0 und 1
- „unter der Bedingung, dass stimmt“
- so weit draußen wie das, was du gemessen hast
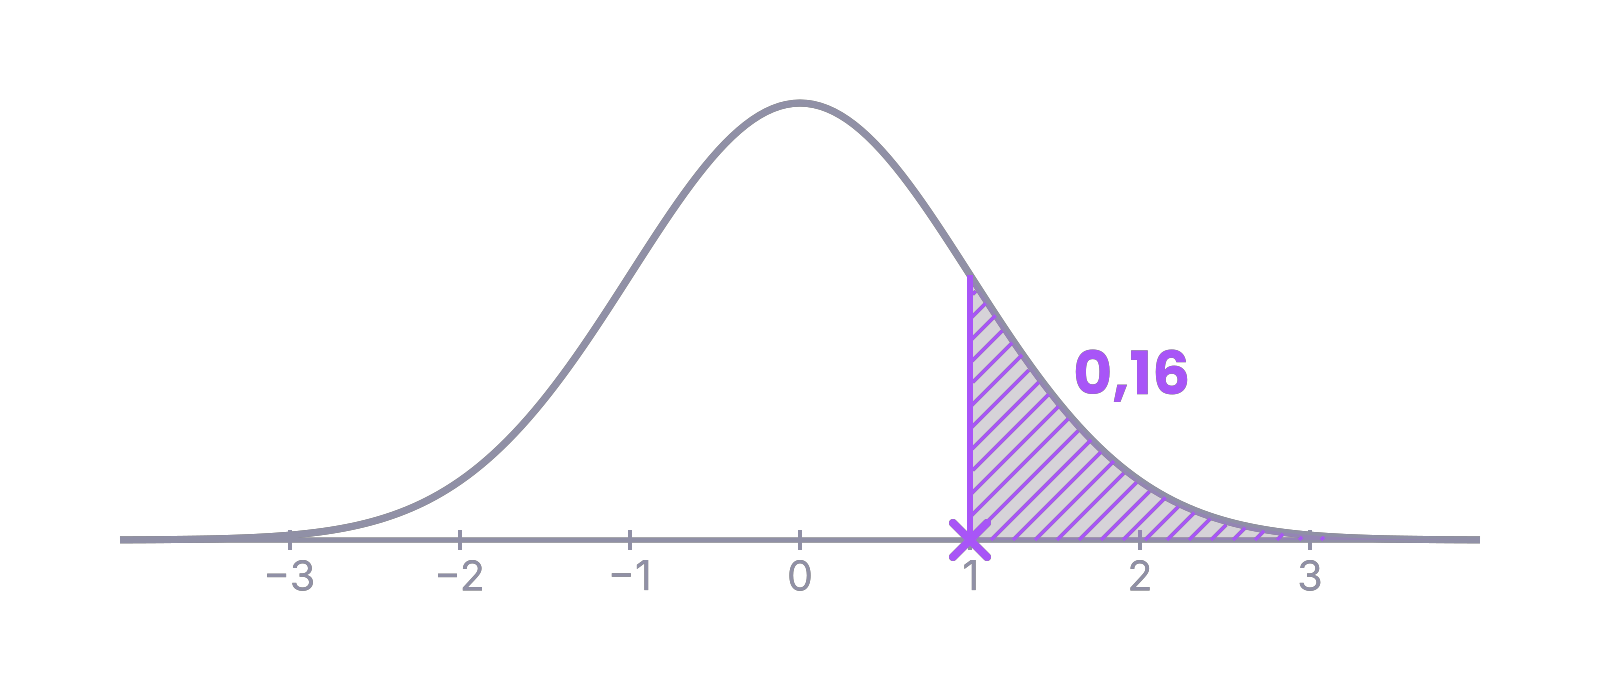
Die Fläche rechts vom Ergebnis ist der p-Wert: bei 1 sind es 0,16, bei 2 nur 0,023.
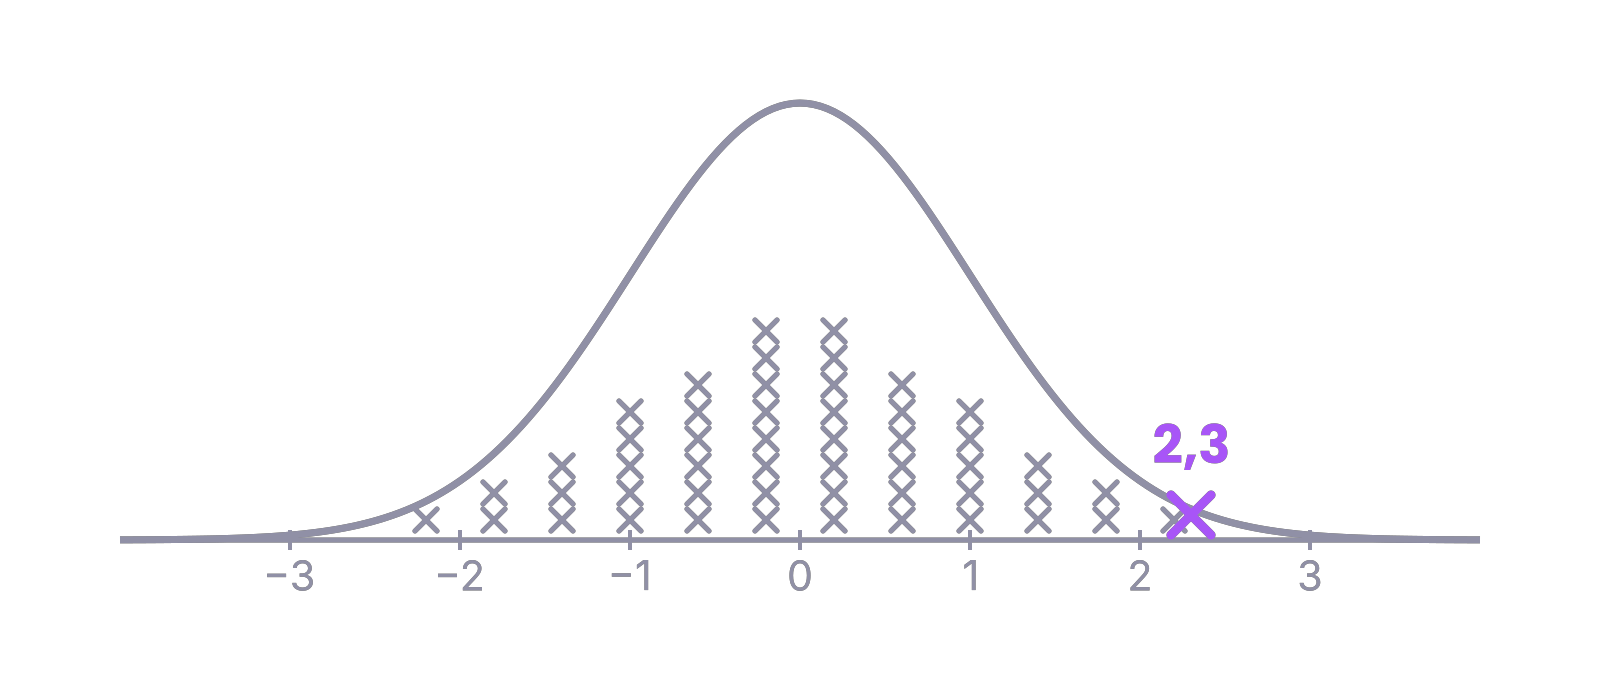
Unter H₀ landen die Ergebnisse meist nahe 0. Ein Ergebnis bei 2,3 ist selten.
Beispiel
Der p-Wert ist nicht die Wahrscheinlichkeit, dass stimmt. Und ein kleiner p-Wert heißt nicht, dass der Effekt groß ist.
Verwandte Formeln
Signifikant oder nicht
Ist p kleiner als α, verwirfst du H₀.
Bevor du testest, legst du eine Grenze fest: . Dann vergleichst du nur noch zwei Zahlen.
Ist kleiner oder gleich 0,05, ist das Ergebnis signifikant. Ist größer, behältst du . „Behalten“ heißt aber nicht „bewiesen“. Es heißt nur: Die Daten reichen nicht.
Was die Zeichen bedeuten
- „alpha“, das Signifikanzniveau: deine Grenze, meist 0,05 (5 %)
- „daraus folgt“
- das Ergebnis ist signifikant
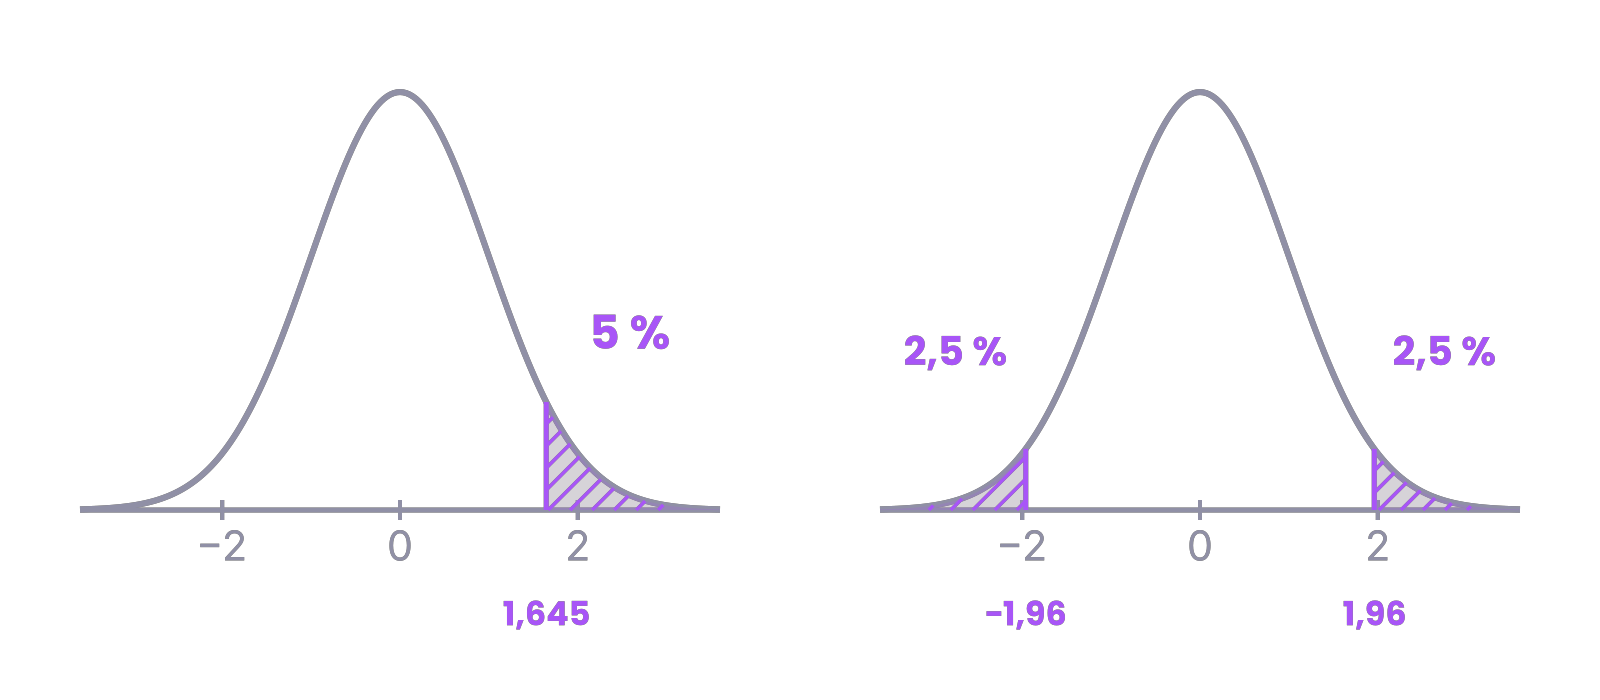
Die Grenze bei 1,645 lässt rechts 5 % übrig. 1,2 liegt davor (nicht signifikant), 2,1 dahinter (signifikant).
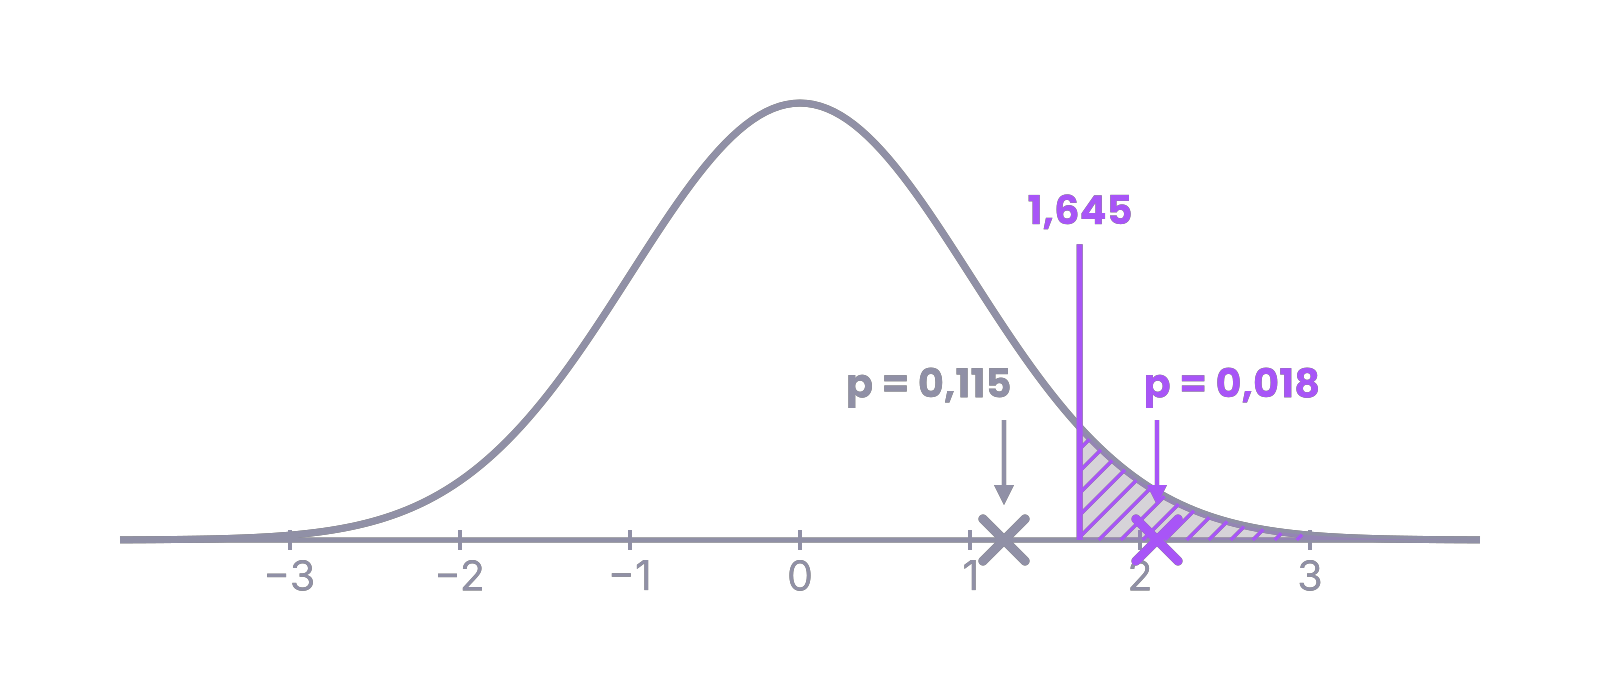
Einseitig liegen die 5 % auf einer Seite, zweiseitig je 2,5 % auf beiden.
Beispiel
Schreib das Ergebnis immer mit dem Beispiel: „Die Daten sprechen für einen positiven Zusammenhang zwischen Licht und Sauerstoffbildung.“
Fehler 1. und 2. Art
Ein Test kann falschen Alarm schlagen oder etwas übersehen.
Denk an einen Rauchmelder. Er piept, obwohl nur Toast angebrannt ist: Fehler 1. Art. Er bleibt still, obwohl es brennt: Fehler 2. Art.
Beim Test ist es genauso. Fehler 1. Art: Du verwirfst , obwohl sie stimmt. Fehler 2. Art: Du behältst , obwohl sie falsch ist. Machst du kleiner, wird größer.
Was die Zeichen bedeuten
- Wahrscheinlichkeit für einen Fehler 1. Art: falscher Alarm
- „beta“, Wahrscheinlichkeit für einen Fehler 2. Art: echten Effekt übersehen
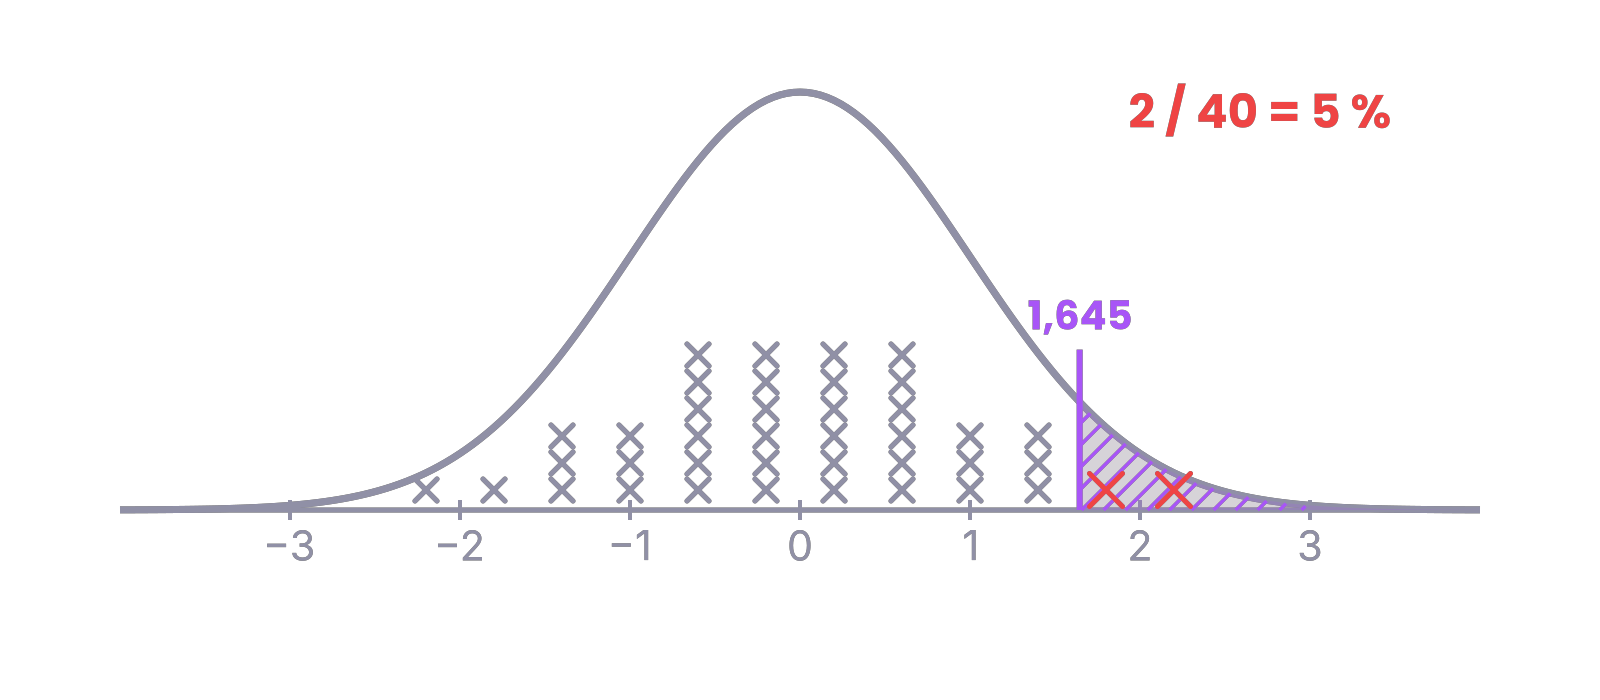
Selbst wenn H₀ stimmt, landen 2 von 40 Ergebnissen im Rand: 5 % falscher Alarm.
α ist der Rand der linken Glocke, β das Stück der rechten Glocke vor der Grenze.
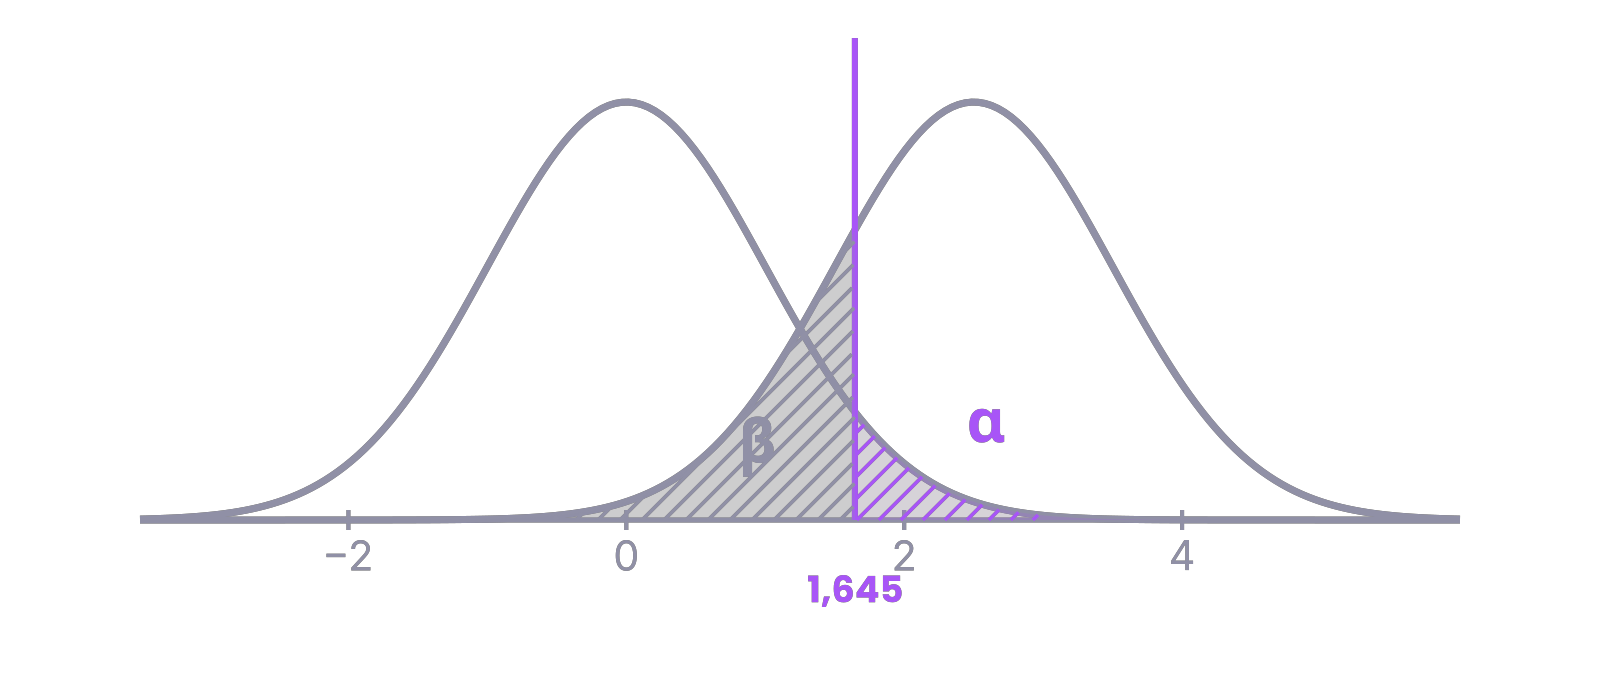
Rückt die Grenze nach rechts, wird α kleiner – aber β größer.
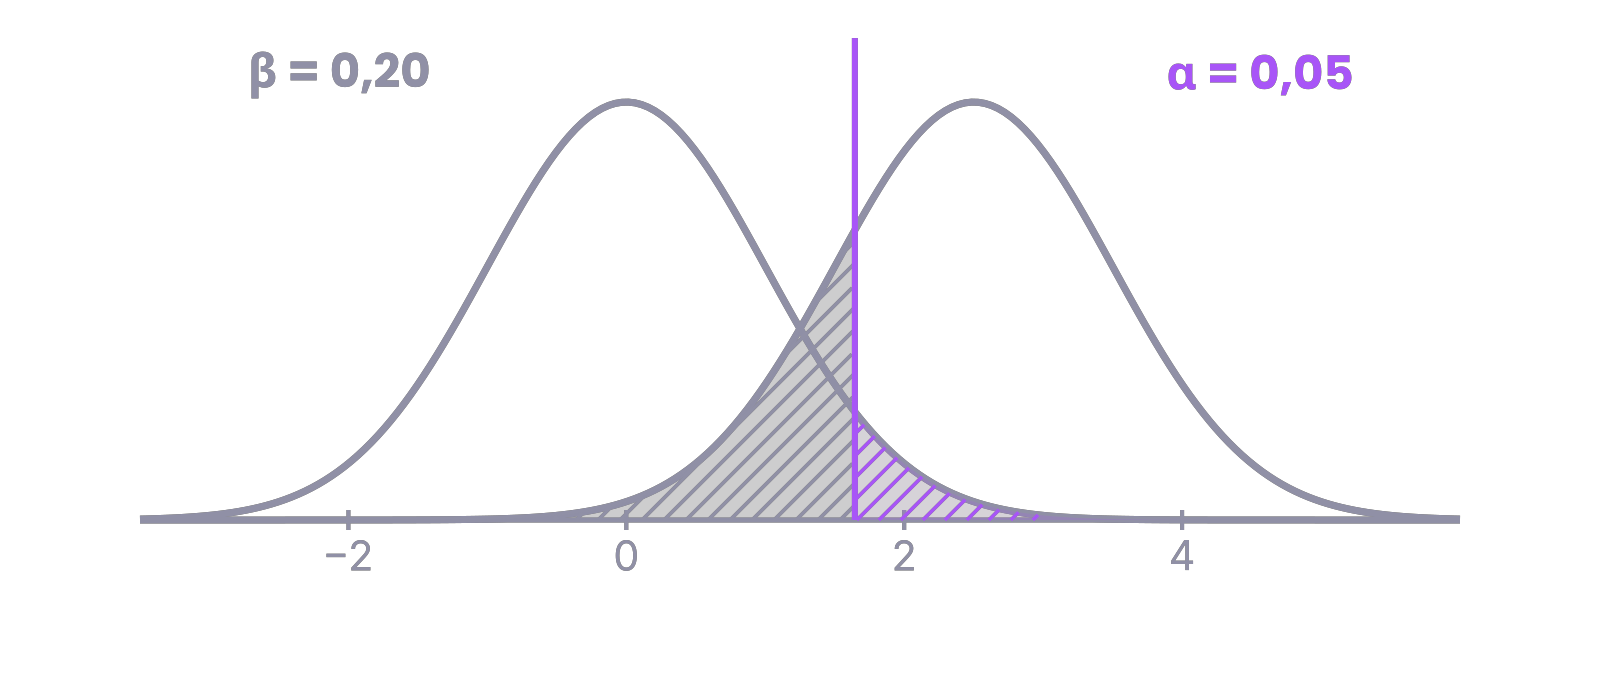
Nach dem Test ist nur einer der beiden Fehler möglich. Wurde verworfen, nur ein Fehler 1. Art. Wurde sie behalten, nur ein Fehler 2. Art.
Verwandte Formeln
Teststärke (Power)
Wie sicher ein Test einen echten Effekt findet.
Ein Test mit hoher Teststärke ist wie eine gute Brille: Er sieht auch kleine Effekte. Mehr Daten machen die Brille besser.
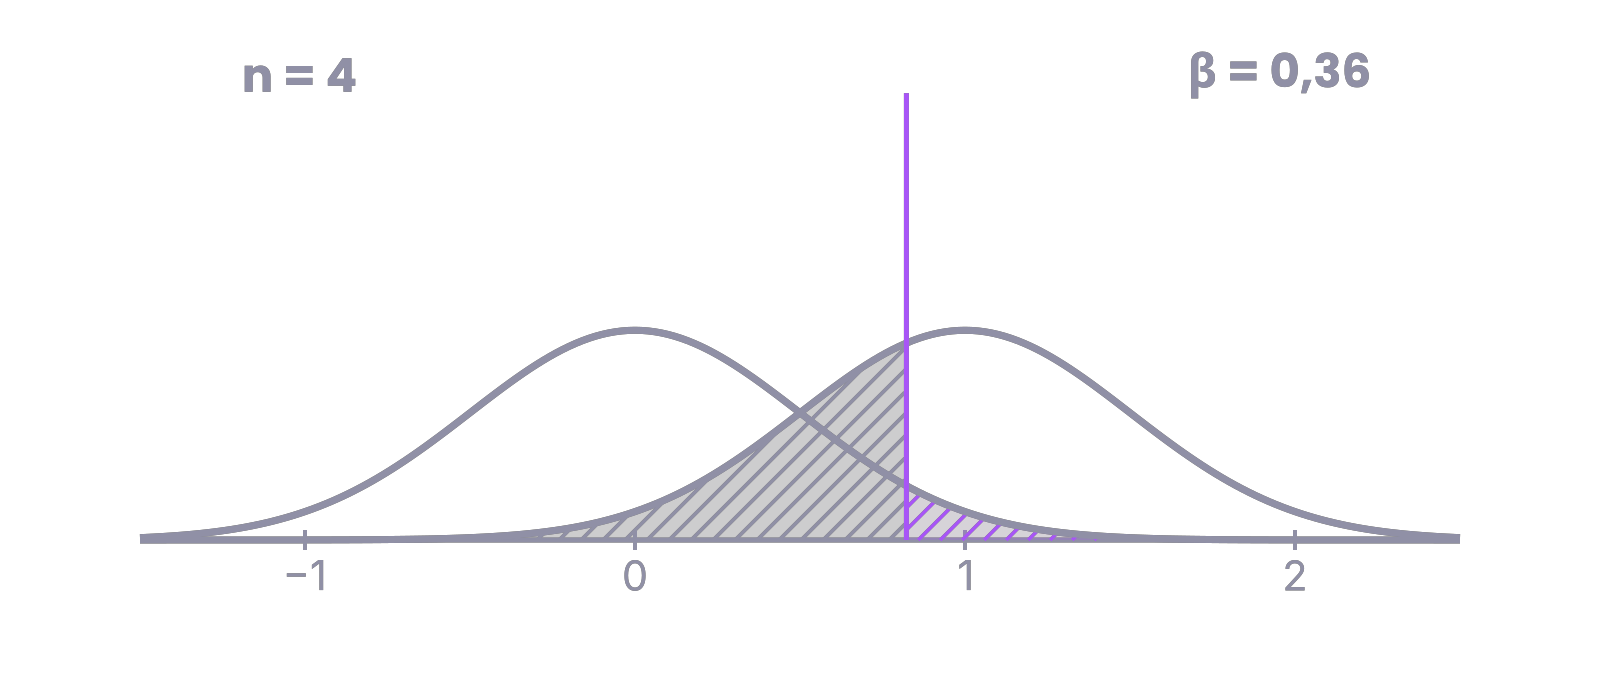
Mit wenigen Pflanzen übersieht der Test einen echten Effekt leicht. Dann ist groß und die Teststärke klein.
Was die Zeichen bedeuten
- Wahrscheinlichkeit, einen echten Effekt zu übersehen
- Wahrscheinlichkeit, ihn zu finden
Mit 4 Pflanzen ist β = 0,36, mit 16 Pflanzen nur 0,01.
Beispiel
Verwandte Formeln
Prüfgröße für einen Mittelwert
Wie viele Standardfehler dein Mittelwert vom erwarteten Wert weg ist.
Das ist derselbe Gedanke wie beim z-Wert. Du misst einen Abstand und zählst ihn in Schritten.
Der Abstand ist: dein Mittelwert minus der Wert aus . Die Schrittlänge ist der Standardfehler. Sind es viele Schritte, ist dein Ergebnis weit draußen – der p-Wert ist klein. Kennst du nicht und nimmst , heißt die Zahl statt .
Was die Zeichen bedeuten
- dein gemessener Mittelwert
- „mü null“, der Wert, den behauptet
- der Standardfehler, also die Schrittlänge
- die Zahl der Schritte
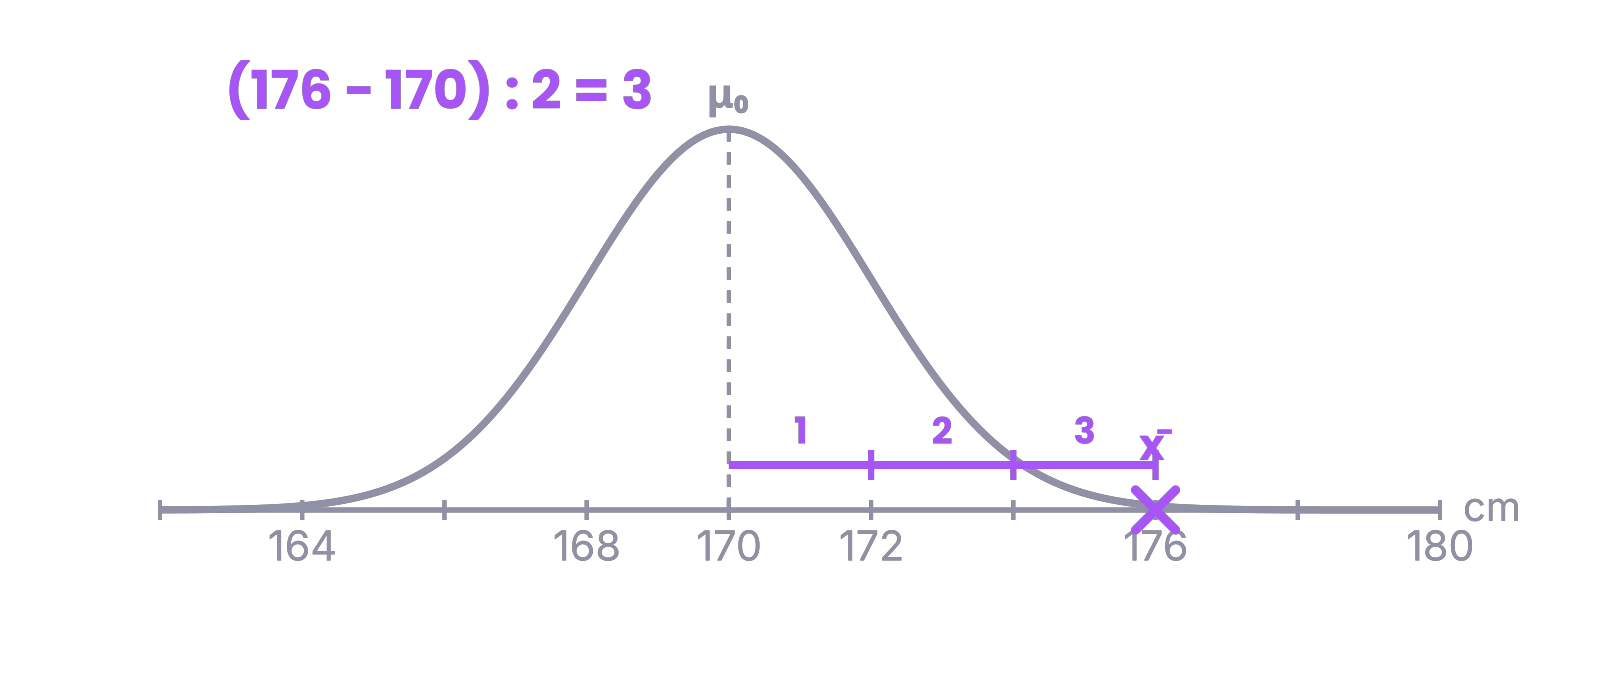
Von 170 bis 176 sind es drei Schritte der Länge 2: z = 3.
Beispiel
Verwandte Formeln
Zusammenhang
Korrelationskoeffizient nach Pearson
Eine Zahl zwischen −1 und 1 für „je mehr, desto mehr“.
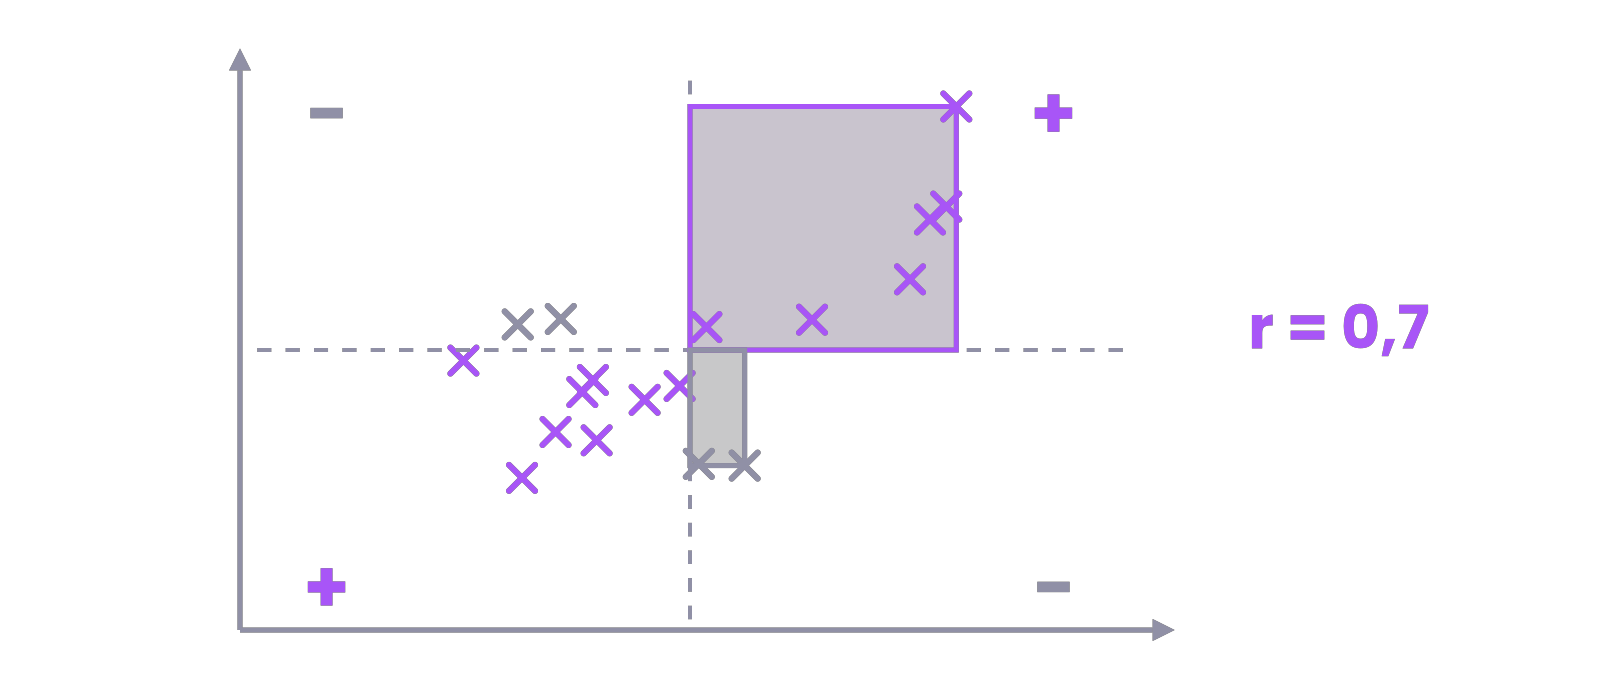
Zieh durch die Punktwolke ein Kreuz durch die beiden Mittelwerte. Jetzt hat jeder Punkt ein Vorzeichen. Rechts oben und links unten heißt plus: Beide Werte sind gleichzeitig groß oder gleichzeitig klein. Links oben und rechts unten heißt minus.
Die Formel zählt alle Plus und Minus zusammen. Überwiegen die Plus, ist positiv. Überwiegen die Minus, ist negativ. Halten sie sich die Waage, ist nahe 0.
Was die Zeichen bedeuten
- der Korrelationskoeffizient
- für jeden Punkt: Abstand nach rechts mal Abstand nach oben, vom Mittelpunkt aus
- oben wird gezählt, unten steht nur, was zwischen −1 und 1 hält
Rechts oben und links unten zählen plus, die anderen minus.
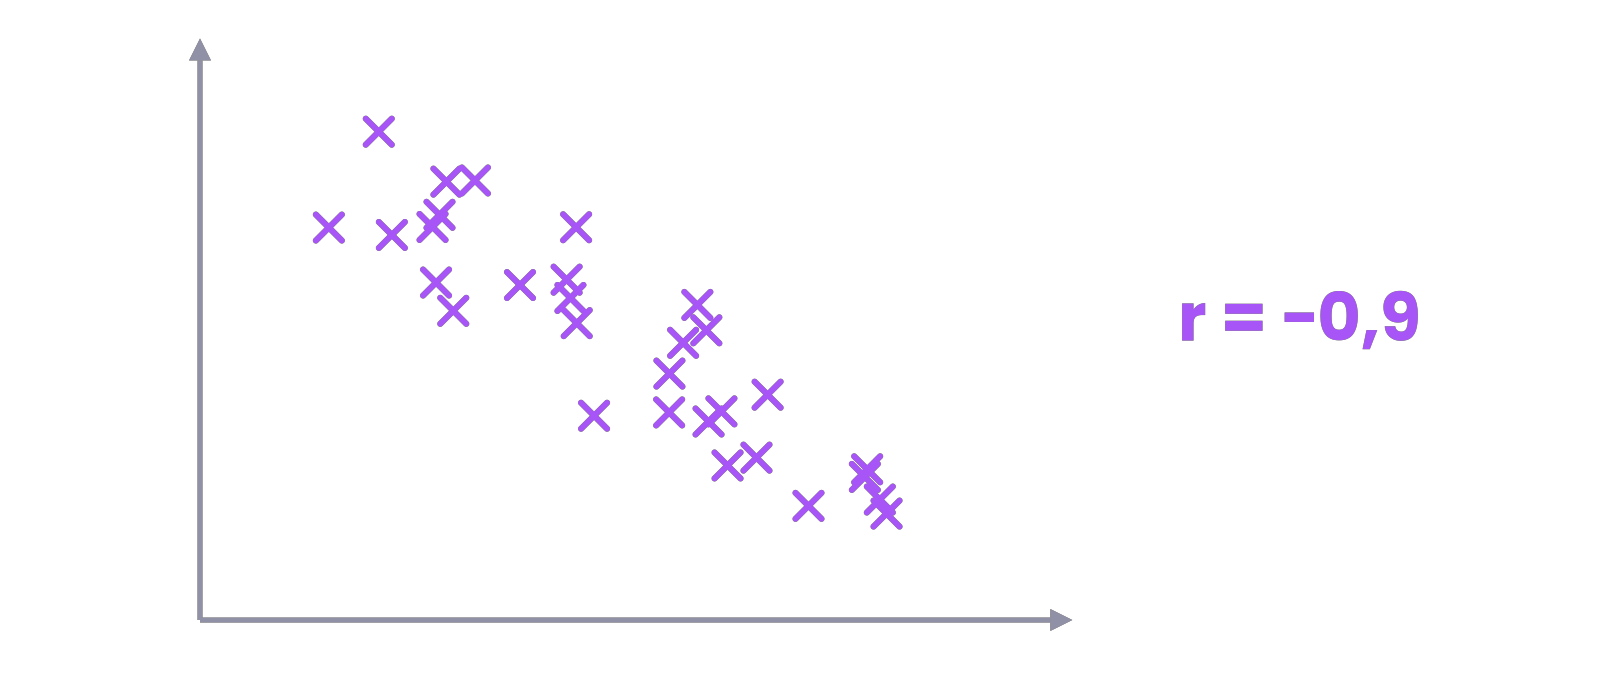
Dieselbe Wolke mit r = −0,9, 0, 0,5 und 0,9.
Beispiel
Ein Zusammenhang zeigt keine Ursache. Oft steckt eine dritte Größe dahinter (Störgröße).
Verwandte Formeln
Test der Korrelation
Ist r so groß, dass es kein Zufall sein kann?
Auch ohne echten Zusammenhang kommt zufällig ein heraus, das nicht genau 0 ist. Der Test fragt: Ist mein dafür zu groß?
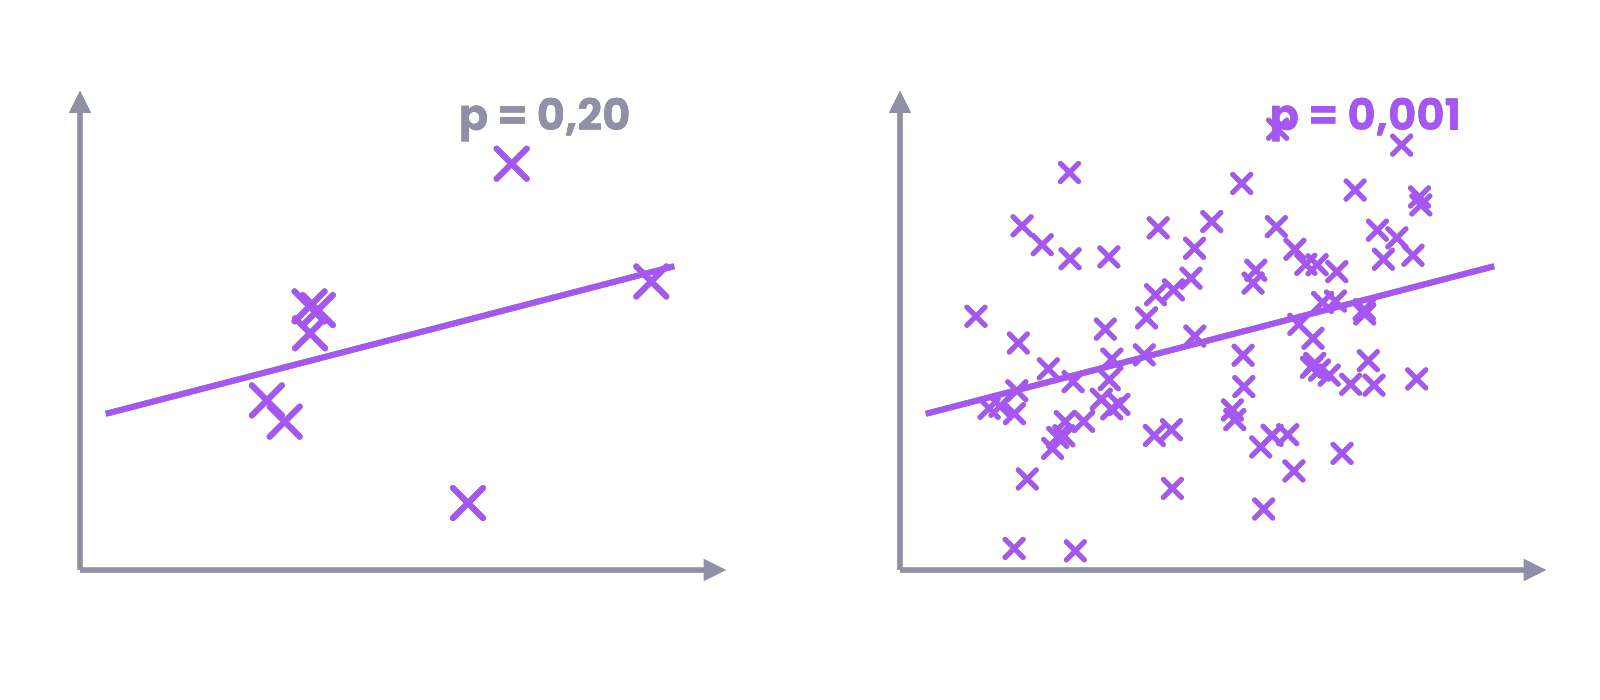
Wichtig ist das in der Formel. Mehr Punkte machen größer. Derselbe Zusammenhang ist mit 8 Pflanzen nicht signifikant, mit 80 Pflanzen sehr deutlich.
Was die Zeichen bedeuten
- der Korrelationskoeffizient deiner Daten
- wie viele Punkte du hast
- die Prüfgröße. Daraus rechnet R den p-Wert
Gleicher Zusammenhang (r = 0,35): mit 8 Pflanzen p = 0,20, mit 80 Pflanzen p = 0,001.
Beispiel
In R macht das cor.test(x, y) für dich. Gib , , die Freiheitsgrade () und an.
Normalverteilung prüfen
Kolmogorow-Smirnow-Test
Der größte Abstand zwischen deinen Daten und der Normalverteilung.
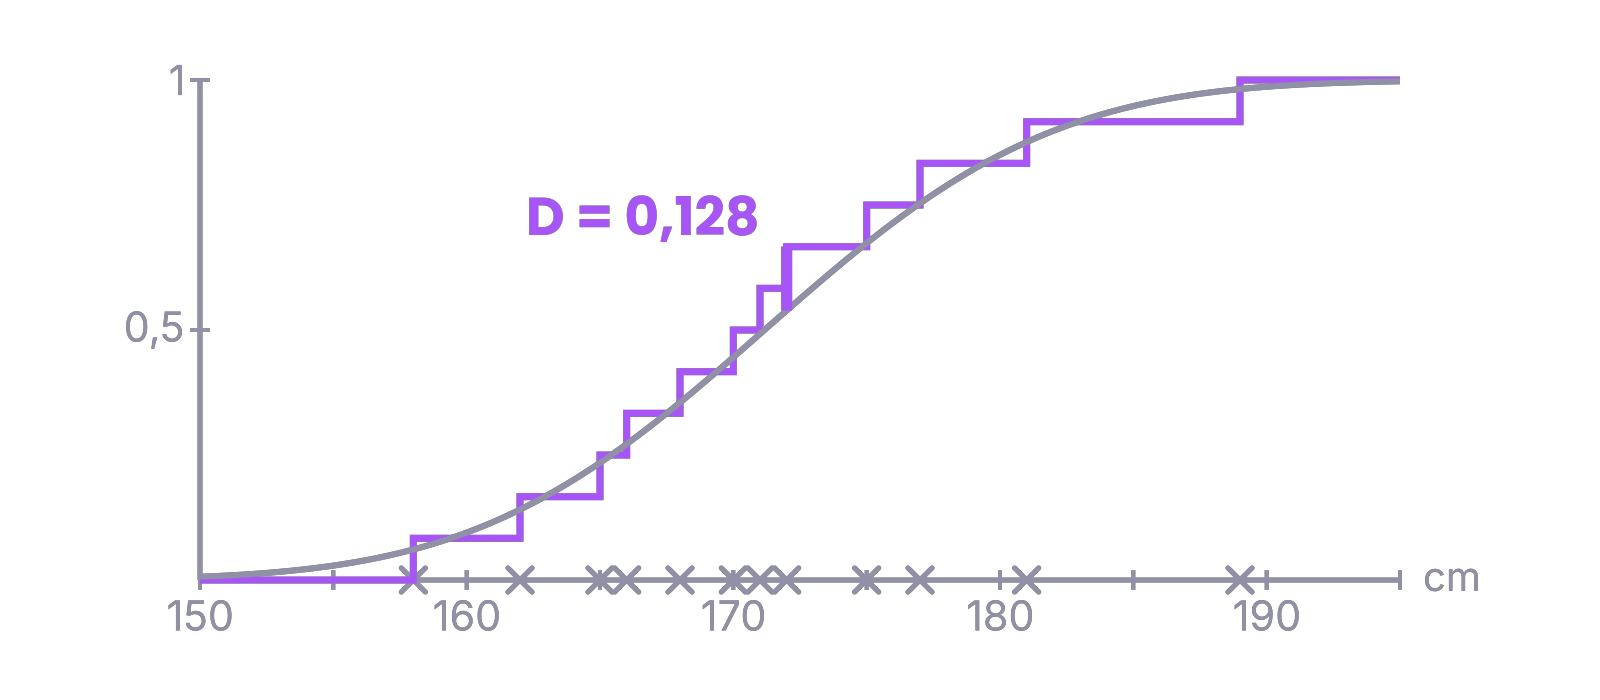
Deine Daten bilden eine Treppe: Bei jedem Wert geht es eine Stufe hoch. Daneben liegt die glatte Kurve der Normalverteilung.
Der Test sucht die Stelle, an der Treppe und Kurve am weitesten auseinander sind. Dieser größte Abstand heißt . Ist klein, passen die Daten zur Normalverteilung.
Was die Zeichen bedeuten
- die Treppe aus deinen Daten: bei jedem Wert eine Stufe nach oben
- die glatte Kurve der Normalverteilung
- der Abstand, egal ob die Treppe drüber oder drunter ist
- der größte dieser Abstände
Zwölf Körpergrößen als Treppe, dazu die Kurve. Der größte Abstand ist bei 172 cm: D = 0,128.
Beispiel
In R: ks.test(x, "pnorm", mean(x, na.rm = TRUE), sd(x, na.rm = TRUE)). Gleiche Werte (ties) machen den p-Wert ungenau.
Verwandte Formeln
Shapiro-Wilk-Test
Eine Zahl W nahe 1 heißt, die Daten passen zur Normalverteilung.
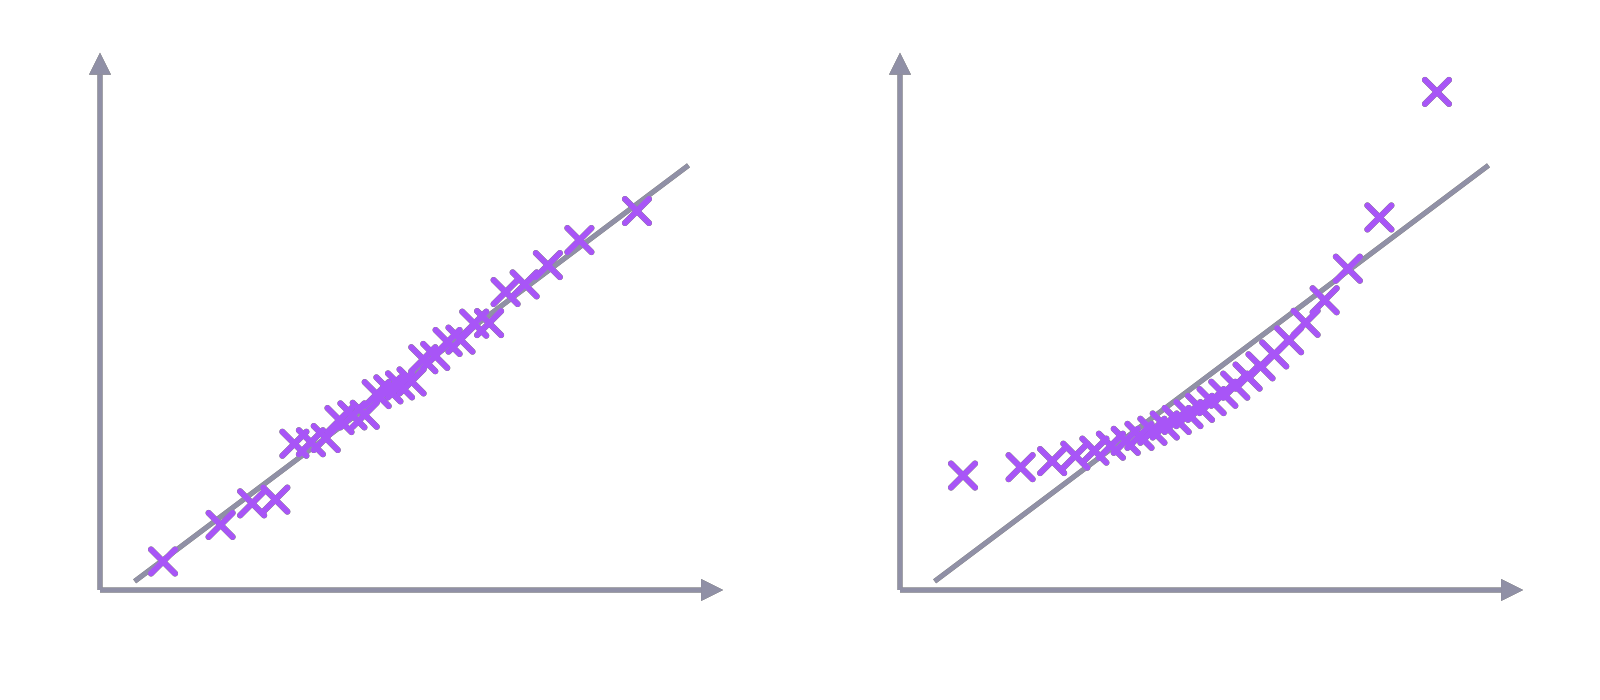
Der Test schaut im Grunde auf den QQ-Plot. Liegen die Punkte schön auf der Geraden, ist fast 1 und groß. Biegen sie sich weg, wird kleiner und klein.
Achtung, hier ist es andersherum als sonst: Meist wünschst du dir . Dann gibt es keinen Hinweis gegen die Normalverteilung.
Was die Zeichen bedeuten
- die Prüfgröße. Je näher an 1, desto gerader liegen die Punkte im QQ-Plot
- hier: „Die Daten sind normalverteilt“
Links liegen die Punkte auf der Geraden (W nahe 1). Rechts hängen sie durch (W kleiner).
Beispiel
beweist keine Normalverteilung. Mit sehr vielen Daten wird schon eine winzige Abweichung signifikant – schau immer auch auf den QQ-Plot.