Das Histogramm: die Daten in Klassen
Ein Histogramm teilt die Werte in gleich breite Klassen ein, zum Beispiel 160 bis 165 cm. Über jeder Klasse steht eine Säule. Ihre Höhe zeigt, wie viele Werte hineinfallen: die absolute Häufigkeit.
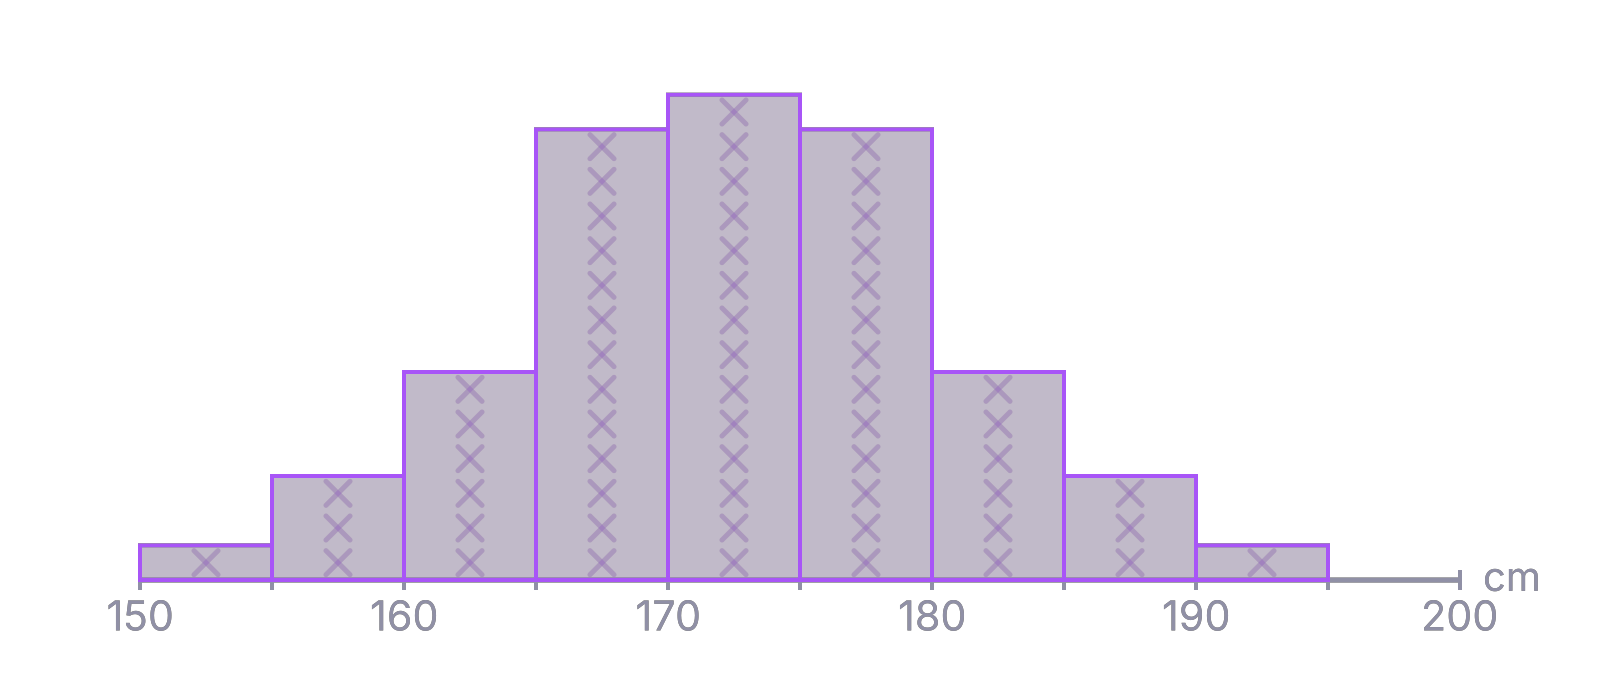
Sieht das Histogramm aus wie eine Glocke – ein Gipfel in der Mitte, auf beiden Seiten gleich abfallend –, passt eine Normalverteilung gut. Ein langer Ausläufer nach rechts heißt rechtsschief, nach links linksschief.
hist(daten$Groesse,
     breaks = seq(from = 150, to = 200, by = 5),   # Klassen von 5 cm
     xlim = c(150, 200), ylim = c(0, 50),          # Achsenbereiche
     main = "Körpergröße der Befragten",           # Überschrift
     xlab = "Körpergröße (cm)", ylab = "Anzahl",   # Achsen beschriften
     col = "red", density = 20, angle = 45)        # rot schraffiert
density ist die Zahl der Schraffurlinien pro Zoll, angle ihr Winkel. Ohne density werden die Säulen ganz gefüllt.Mit breaks = seq(150, 200, by = 5) – wie viele Klassen hat das Histogramm?
Tipp eine Zahl ein. Dann prüfen.
. Von 150 bis 200 cm sind es 50 cm, in Schritten von 5 cm also Klassen.
Teildaten auswählen und fehlende Werte
Oft sollst du nur einen Teil der Daten untersuchen, zum Beispiel nur die Befragten einer Gruppe. Dafür gibt es subset(). Es behält nur die Zeilen, für die die Bedingung stimmt.
frauen <- subset(daten, Geschlecht == "weiblich")   # nur diese Zeilen
nrow(frauen)                                         # wie viele sind es?

mean(frauen$Groesse, na.rm = TRUE)   # Mittelwert ohne fehlende Werte
sd(frauen$Groesse, na.rm = TRUE)     # Standardabweichung ohne fehlende Werte
Fehlt ein Wert, steht in R NA (not available). Dann ergibt mean() ebenfalls NA. Mit na.rm = TRUE lässt R die fehlenden Werte weg.
Welche Zeile wählt alle Befragten aus, die rauchen?
Wähle eine Antwort. Dann prüfen.
subset(daten, Raucher == "Ja"). Vergleichen heißt ==, und der Text „Ja“ braucht Anführungszeichen.
Der QQ-Plot: Liegen die Punkte auf der Geraden?
Im QQ-Plot (Quantil-Quantil-Diagramm) werden die Daten der Größe nach sortiert. Jeder Wert bekommt einen Partner: den Wert, den man an derselben Stelle bei einer Normalverteilung erwarten würde. Auf der x-Achse stehen diese theoretischen Quantile, auf der y-Achse die Daten.
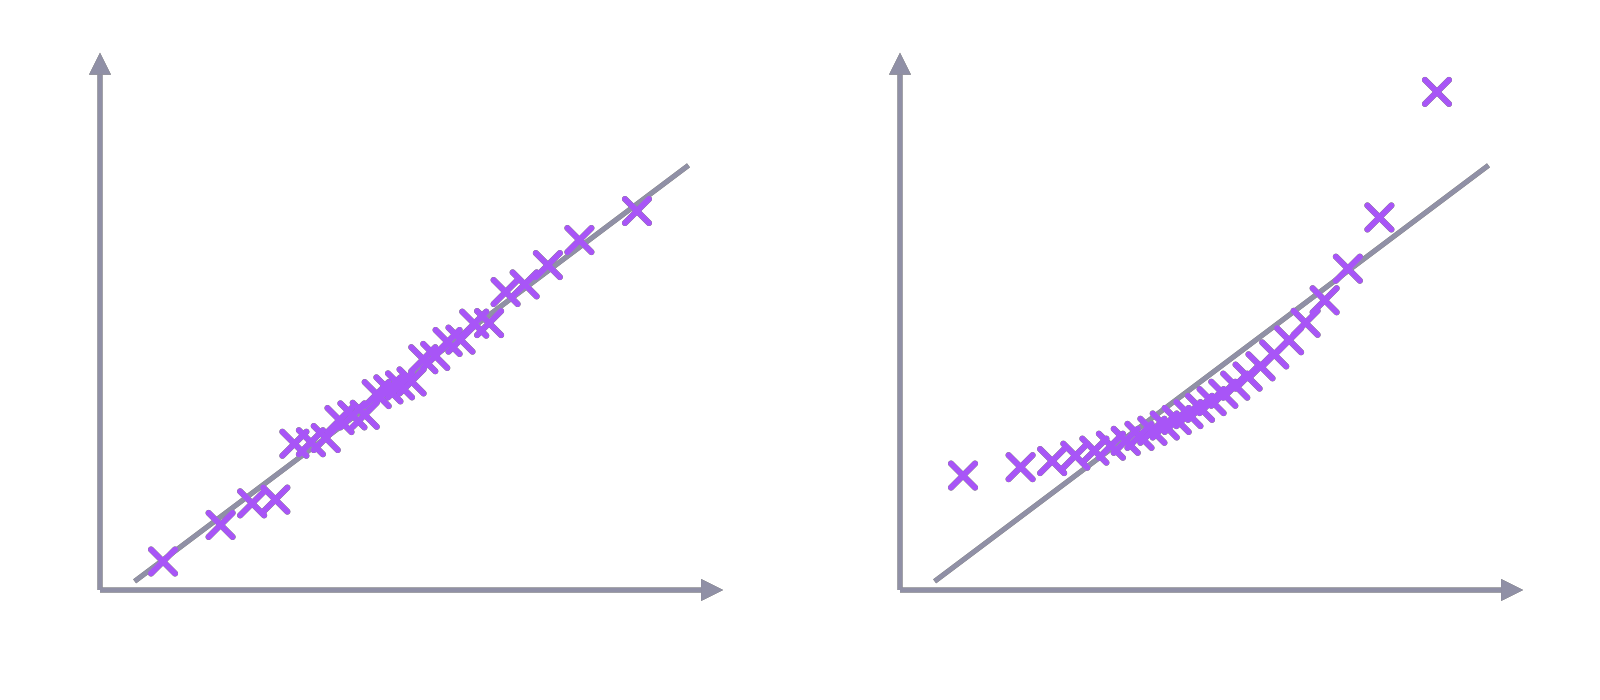
Sind die Daten normalverteilt, liegen die Punkte nahe an einer Geraden. Wie sie abweichen, verrät die Form:
| Form im QQ-Plot | bedeutet |
|---|---|
| Form im QQ-PlotPunkte auf der Geraden, kleine Zacken | bedeutetpasst zur Normalverteilung |
| Form im QQ-PlotBogen nach unten durchhängend (wie ein U) | bedeutetrechtsschief: langer Ausläufer zu großen Werten |
| Form im QQ-PlotBogen nach oben (wie ein umgedrehtes U) | bedeutetlinksschief: langer Ausläufer zu kleinen Werten |
| Form im QQ-PlotS-Form, Enden weg von der Geraden | bedeutetmehr extreme Werte als bei einer Normalverteilung |
| Form im QQ-PlotStufen, viele Punkte auf gleicher Höhe | bedeutetgerundete Werte, zum Beispiel ganze Zentimeter |
qqnorm(frauen$Groesse)   # QQ-Plot
qqline(frauen$Groesse) # Gerade zum VergleichIm QQ-Plot liegen die Punkte in der Mitte auf der Geraden. Die größten Werte liegen deutlich darüber. Was heißt das?
Wähle eine Antwort. Dann prüfen.
Es gibt mehr sehr große Werte, als bei einer Normalverteilung zu erwarten wären. Der rechte Ausläufer ist länger.
Der Shapiro-Wilk-Test
Der Shapiro-Wilk-Test prüft mit einem p-Wert, ob die Daten zu einer Normalverteilung passen. Seine Prüfgröße liegt zwischen 0 und 1. Je näher an 1, desto besser liegen die Punkte im QQ-Plot auf einer Geraden.
- : Die Körpergröße ist normalverteilt.
- : Die Körpergröße ist nicht normalverteilt.
shapiro.test(frauen$Groesse)

#   Shapiro-Wilk normality test
# data:  frauen$Groesse
# W = 0.9812, p-value = 0.2736          (Beispielausgabe)
Vollständig angeben heißt: Name des Tests, Prüfgröße, p-Wert, Stichprobengröße und Entscheidung. Etwa so: „Shapiro-Wilk-Test: , , . Da , behalten wir bei. Die Daten geben keinen Hinweis darauf, dass die Körpergröße nicht normalverteilt ist.“
Shapiro-Wilk-Test: , . Was folgt bei ?
Wähle eine Antwort. Dann prüfen.
, also wird verworfen. Die Daten weichen signifikant von einer Normalverteilung ab. Wie stark, zeigt der QQ-Plot.
Der Kolmogorow-Smirnow-Test: der größte Abstand
Der KS-Test vergleicht zwei Verteilungsfunktionen. Die eine kommt aus den Daten: Sie springt bei jedem Wert um nach oben, wie eine Treppe (empirische Verteilungsfunktion). Die andere ist die Verteilungsfunktion der Normalverteilung. Die Prüfgröße ist der größte senkrechte Abstand zwischen beiden.
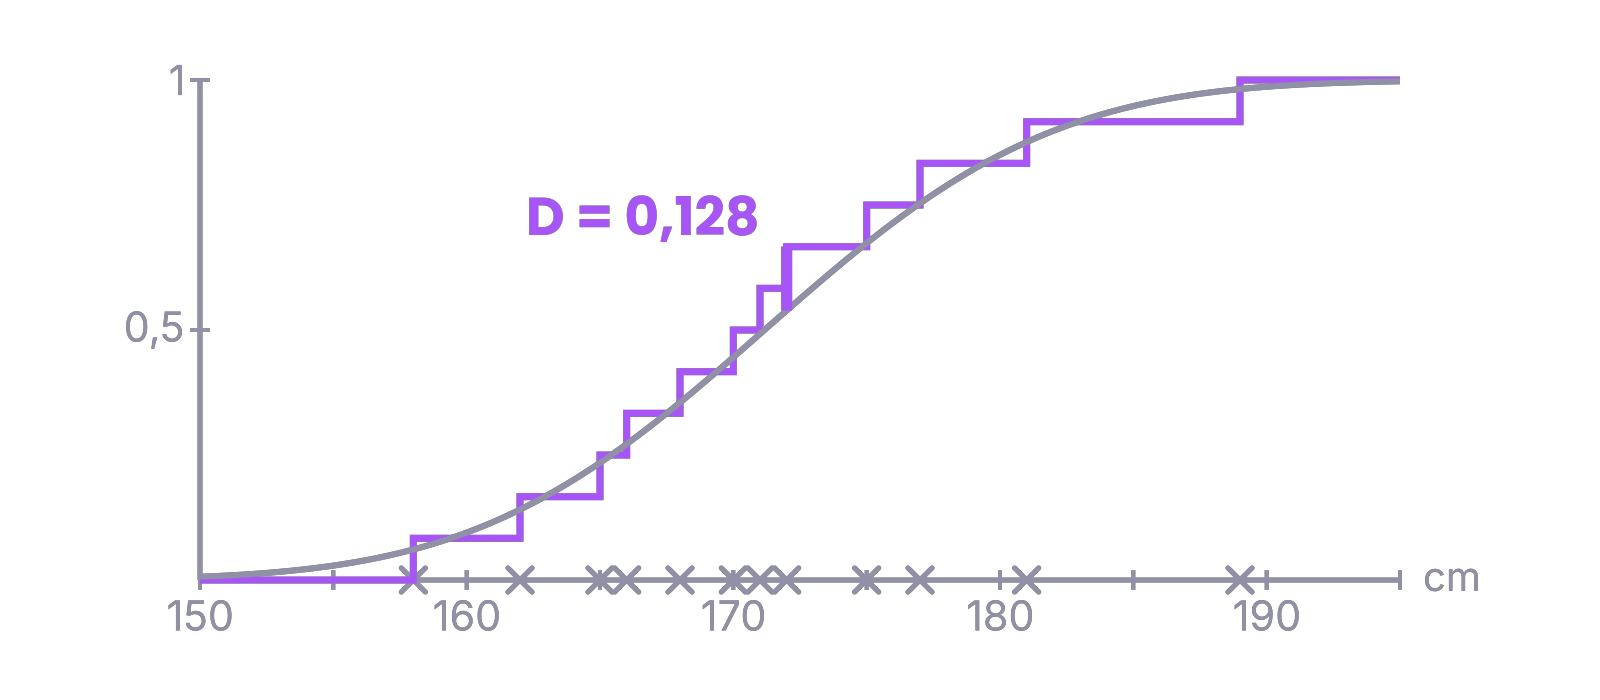
Ist klein, passt die Normalverteilung. Ist groß, wird der p-Wert klein. In R gibst du die Normalverteilung mit Mittelwert und Standardabweichung der Daten an. Fehlen Werte, muss bei mean und sd wieder na.rm = TRUE stehen.
ks.test(frauen$Groesse, "pnorm",
        mean = mean(frauen$Groesse, na.rm = TRUE),
        sd   = sd(frauen$Groesse, na.rm = TRUE))

#   Asymptotic one-sample Kolmogorov-Smirnov test
# D = 0.0874, p-value = 0.5321           (Beispielausgabe)
# Warnmeldung: ties should not be present for the one-sample Kolmogorov-Smirnov test
Die Warnung „ties“ heißt: Manche Werte kommen mehrfach vor, etwa weil die Körpergröße in ganzen Zentimetern angegeben ist. Der KS-Test ist für Daten ohne gleiche Werte gedacht. Sein p-Wert ist dann nur ungefähr richtig.
Was misst die Prüfgröße des KS-Tests?
Wähle eine Antwort. Dann prüfen.
Den größten senkrechten Abstand zwischen der Treppe der Daten und der Verteilungsfunktion der Normalverteilung. Die dritte Antwort beschreibt eher den Shapiro-Wilk-Test.
Wenn die Verfahren sich widersprechen
Es kommt oft vor: Der Shapiro-Wilk-Test ist signifikant, der KS-Test nicht. Oder beide Tests sind nicht signifikant, aber der QQ-Plot sieht schief aus. Dafür gibt es mehrere Gründe.
- Unterschiedliche Teststärke. Der Shapiro-Wilk-Test findet Abweichungen viel eher. Der KS-Test übersieht sie öfter, vor allem mit geschätztem Mittelwert und geschätzter Standardabweichung. Er macht also eher einen Fehler 2. Art.
- Unterschiedliche Stellen. Der KS-Test achtet vor allem auf die Mitte der Verteilung, wo die Treppe am steilsten ist. Abweichungen in den Rändern bemerkt er kaum. Der Shapiro-Wilk-Test reagiert auch auf die Ränder.
- Die Stichprobengröße. Bei wenigen Werten wird fast nichts signifikant. Bei sehr vielen Werten wird schon eine winzige Abweichung signifikant, die für die weitere Auswertung keine Rolle spielt.
- Gleiche Werte (ties). Gerundete Werte stören den KS-Test, und im QQ-Plot entstehen Stufen.
Der QQ-Plot zeigt, was die Tests nicht zeigen: wo die Daten abweichen und wie stark. Eine kleine Zacke in der Mitte ist harmlos. Ein langer Ausläufer nach rechts kann wichtig sein.
Bei 2000 Körpergrößen ergibt der Shapiro-Wilk-Test . Der QQ-Plot zeigt eine fast perfekte Gerade. Was ist die beste Erklärung?
Wähle eine Antwort. Dann prüfen.
Bei 2000 Werten hat der Test eine sehr hohe Teststärke. Schon eine winzige, harmlose Abweichung wird signifikant. Der QQ-Plot zeigt, dass sie kaum eine Rolle spielt.